요약. 같은 AI라도 어떻게 묻느냐에 따라 답이 달라집니다. 잘 묻는 방법은 크게 세 가지입니다. 원하는 것을 구체적으로 적기, 질문과 답의 예시를 몇 개 함께 보여 주기(퓨샷), 바로 답하지 말고 풀이 과정을 먼저 써 보게 하기(생각의 사슬)입니다. 2022년 연구에서는 질문 뒤에 "단계별로 생각해 보자" 한 줄만 붙여도 수학 문제 정답률이 몇 배로 올랐습니다. 다만 최신 Claude 모델처럼 답하기 전에 스스로 생각하는 기능이 있는 모델에는, 이 한 줄 대신 그 기능에 맡기라는 것이 공식 권고입니다.
2화에서 이어지는 질문: 모델에게 어떻게 말해야 할까
2화 "AI는 글자만 쓰는데, 어떻게 도구를 쓸까?"에서 모델은 도구를 직접 누르지 않고, 무엇을 부를지 "결정"만 한다고 했습니다. 1화의 에이전트도 매 단계 다음에 할 일을 결정합니다.
그럼 모델은 무엇을 보고 결정할까요? 우리가 보낸 글, 즉 프롬프트(모델에게 보내는 질문과 지시)뿐입니다. 그래서 같은 모델이라도 프롬프트를 어떻게 쓰느냐에 따라 결정이 달라집니다.
이번 화에서는 두 가지를 알아봅니다. 같은 모델에게 어떻게 말하면 더 잘 답할까요? 그리고 자주 들리는 "단계별로 생각해 봐"는 정말 효과가 있을까요?
같은 모델, 다른 답: 지시를 구체적으로
원본 레슨 11-01 Prompt Engineering은 이렇게 시작합니다. 모델에게 보낸 글은 단어 하나까지 모두 "이렇게 해 달라"는 요청으로 읽히고, 모델은 그 말을 곧이곧대로 따른다는 것입니다.
"마케팅 메일 써 줘"라고만 하면 어디서 본 듯한 메일이 나옵니다. 누가 읽는지, 어떤 말투인지, 몇 줄인지, 꼭 넣을 숫자와 마지막에 누를 버튼 문구까지 정해 주면 같은 모델에서 전혀 다른 메일이 나옵니다. 레슨은 답이 평범한 이유를 모델이 아니라 질문에서 찾습니다.
레슨이 꼽는 기본기는 이렇습니다.
- 역할: "당신은 ~입니다"로 시작해 관점을 정합니다.
- 지시: 형식, 길이, 독자, 넣을 것과 뺄 것을 적습니다.
- 출력 형식: 번호 목록, 표, JSON처럼 답의 모양을 정합니다.
- 제약: "하지 마라", "항상 해라", "만약 ~면 ~해라".
여기까지는 사람에게 일을 맡길 때와 다르지 않습니다. 이번 화에서 더 들여다볼 것은 두 가지입니다. 예시를 함께 주는 방법, 그리고 답보다 풀이를 먼저 쓰게 하는 방법입니다.
퓨샷 프롬프트: 견본 서류를 먼저 보여 준다
서류 양식을 처음 받으면 작성 요령을 길게 읽는 것보다, 다 채워진 견본 한두 장을 보는 게 빠릅니다. 모델도 비슷합니다.
질문만 주는 방식을 제로샷이라고 부릅니다. 질문 앞에 "이런 질문에는 이렇게 답한다"는 예시를 몇 개 붙이는 방식이 퓨샷입니다. 예시를 준다고 모델 자체가 바뀌지는 않습니다. 그 대화 안에서만 통하는 본보기입니다.
원본 레슨 11-02 Few-Shot, Chain-of-Thought의 예제 코드는 같은 수학 문제를 세 가지로 묻습니다. 그림 1은 이때 코드가 실제로 만드는 프롬프트입니다.
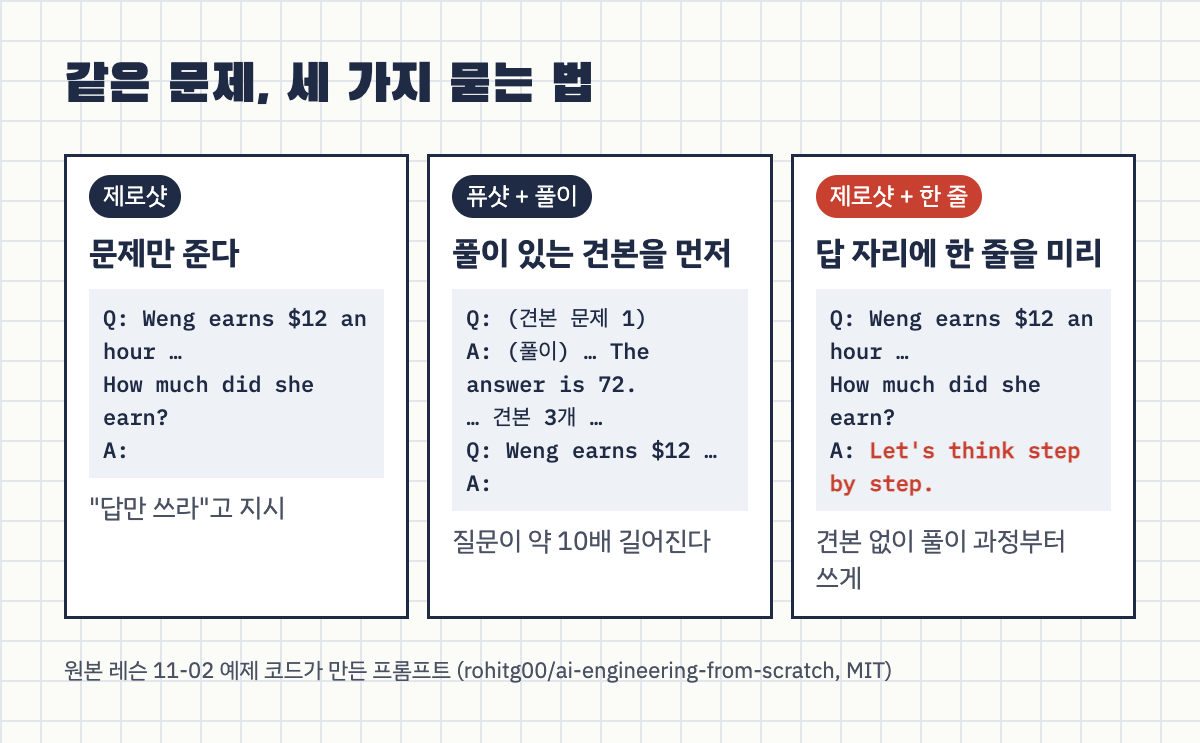
그림 1. 차이는 문장 몇 개입니다. 퓨샷은 견본 3개 때문에 질문이 약 10배 길어집니다.
다만 예시를 붙이는 데도 비용이 듭니다. 쓸 만한 예시를 고르는 데 시간이 들고, 예시가 많을수록 프롬프트가 길어져 요금과 응답 시간도 늘어납니다.
생각의 사슬(Chain-of-Thought): 암산 대신 연습장에 풀기
그림 1의 세 번째 칸을 보세요. 답 자리에 "Let's think step by step(단계별로 생각해 보자)"을 미리 써 둡니다. 그러면 모델은 숫자부터 내놓지 않고 풀이를 먼저 씁니다. 이렇게 답을 내기 전에 풀이 과정을 먼저 쓰게 하는 방법을 생각의 사슬(Chain-of-Thought, CoT) 이라고 부릅니다.
비유하면 암산 대신 연습장에 푸는 것입니다. 레슨도 이를 연습장(scratch paper)이라고 부릅니다. 언어 모델은 앞에 쓴 글자를 보고 다음 글자를 정합니다. 그래서 중간 계산을 글로 써 두면, 그 계산이 다음 단계의 근거가 됩니다. 모델이 사람처럼 생각한다는 뜻은 아닙니다. 써 둔 글자가 다시 읽힌다는 뜻입니다.
효과는 생각보다 컸습니다. 2022년에 나온 한 연구는 이 한 줄만 붙여 수학 문장제 정답률이 어떻게 바뀌는지 쟀습니다.
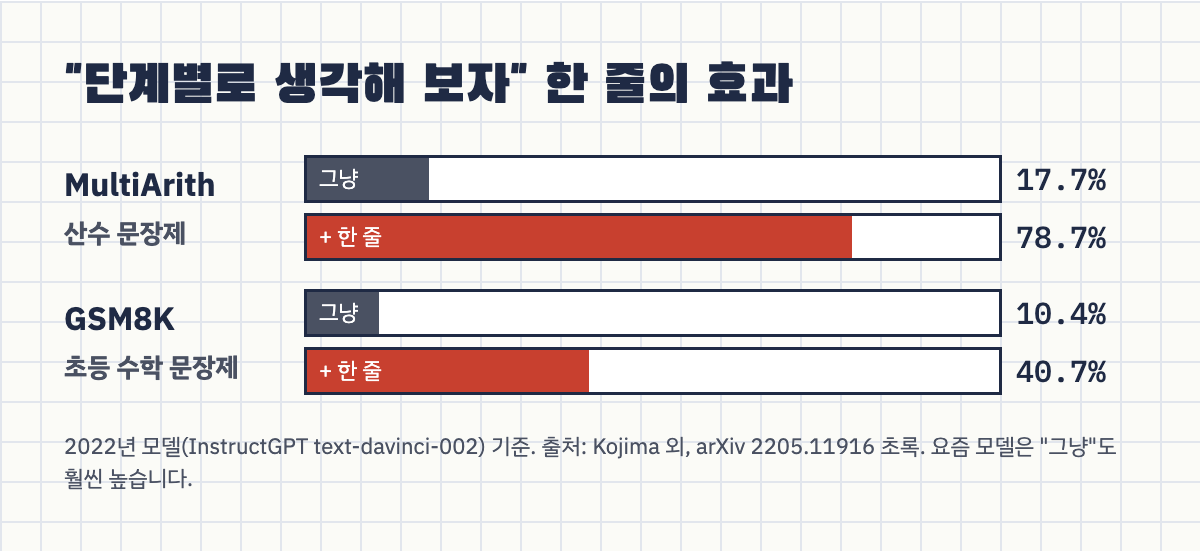
그림 2. 2022년 모델 기준 숫자입니다. 출처는 아래 "더 깊이"에 있습니다.
이 숫자를 지금 모델에 그대로 대입하면 안 됩니다. 요즘 모델은 한 줄 없이도 이 문제들을 훨씬 잘 풉니다. 그래도 풀이를 쓰게 하면 좋은 점이 하나 남습니다. 틀렸을 때 어디서 틀렸는지 읽을 수 있다는 것입니다.
생각의 사슬이 늘 이득은 아닙니다. 레슨은 단순한 사실 질문이나 한 단계짜리 분류에서는 글자만 늘고 얻는 게 없다고 봅니다.
자기 일관성: 여러 번 풀게 하고 다수결
한 걸음 더 나간 방법도 있습니다. 같은 문제를 여러 번 풀게 하고, 가장 많이 나온 답을 고르는 것입니다. 이를 자기 일관성(Self-Consistency) 이라고 부릅니다.
매번 조금씩 다르게 풀도록 temperature(답의 무작위성을 정하는 값)를 조금 올려 둡니다. 풀이 과정은 버리고 마지막 답만 셉니다. 원본 레슨 11-02의 예시 풀이 다섯 개를 레슨 코드의 투표 함수에 넣으면 그림 3처럼 나옵니다.
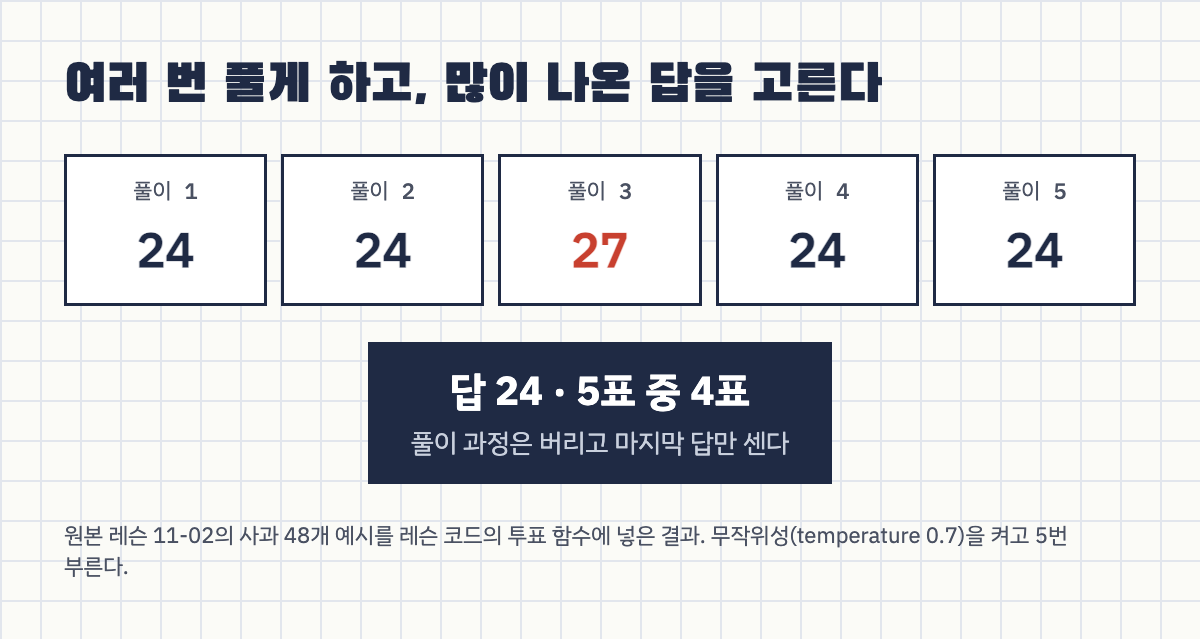
그림 3. 다섯 번 중 네 번 나온 24를 답으로 고릅니다.
단점도 분명합니다. 다섯 번 부르면 비용도 다섯 배입니다. 다섯 번이 모두 같은 방향으로 틀리면 투표로도 고칠 수 없습니다.
견본의 실수도 그대로 따라 한다
퓨샷에는 함정이 하나 있습니다. 모델은 견본의 좋은 점만 따라 하지 않습니다.
원본 레슨 11-02의 견본 풀이는 "The answer is 72."처럼 마침표로 끝납니다. 그런데 레슨의 채점 코드는 마침표까지 숫자로 읽어 72.와 72를 다른 답으로 봅니다. 모든 문제를 맞히는 가짜 모델이 견본 형식대로 답하게 하고 채점하면 그림 4처럼 나옵니다.
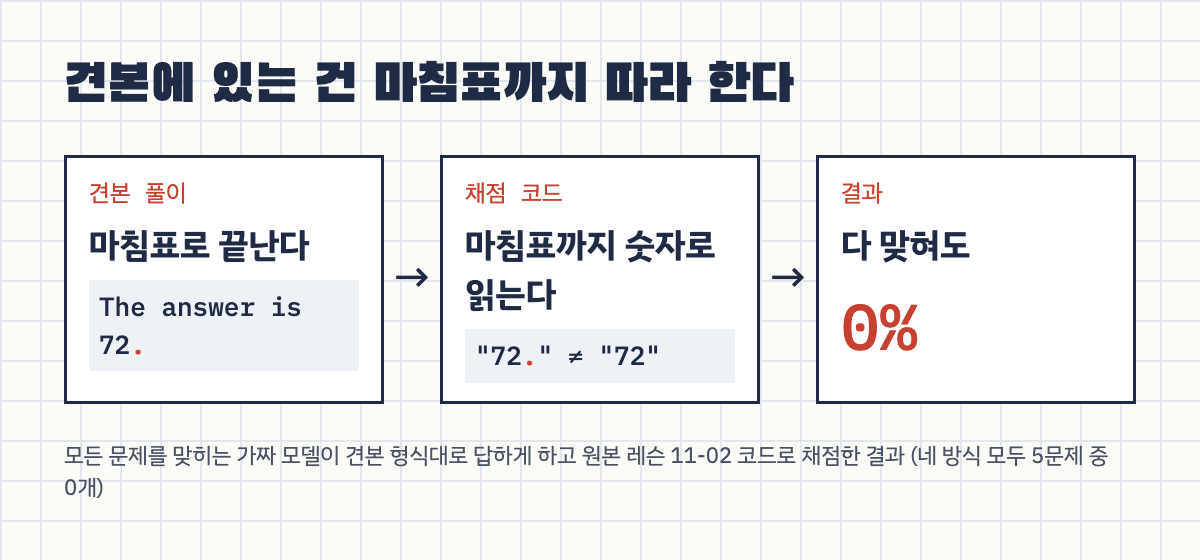
그림 4. 네 방식 모두 다섯 문제를 다 맞히고도 0%로 채점됩니다.
같은 레슨의 견본 하나는 원래 수학 문제와 조건이 달라져 있었고, 풀이도 원래 정답과 다른 답으로 끝났습니다. 기본 설정에서는 쓰이지 않는 견본이지만, 견본 수를 늘리면 틀린 풀이가 모범 답안으로 들어갑니다. 그래서 견본을 쓰기 전에 견본부터 검사해야 합니다.
최신 Claude 모델에도 통할까
위 숫자는 2022년 모델로 잰 것입니다. 요즘 모델에도 그대로 통할까요? 2026년 10월 기준 Claude 공식 문서 "Prompting best practices"로 확인해 보면, 네 가지 중 둘은 그대로이고 둘은 달라졌습니다.
- 구체적인 지시: 오히려 더 중요해졌습니다. 문서는 최신 Claude 모델이 지시를 정확히 따르도록 학습됐다고 설명합니다. 원하는 게 있으면 모델이 알아서 짐작하길 기대하지 말고 분명히 적으라고 합니다. 문서는 Claude를 "똑똑하지만 우리 팀 사정은 모르는 신입 직원"에 빗댑니다.
- 예시(퓨샷): 여전히 권장합니다. 문서는 예시를 답의 형식, 말투, 구조를 맞추는 가장 믿을 만한 방법 중 하나로 꼽고, 3~5개를 권합니다. 대신 예시끼리 충분히 다르게 만들라고 합니다. 의도하지 않은 패턴까지 따라 할 수 있어서입니다. 앞에서 본 마침표 사례와 같은 이야기입니다.
- "단계별로 생각해 봐": 이제는 대안입니다. 최신 Claude 모델에는 답하기 전에 따로 생각하는 기능(thinking)이 있습니다. 문서는 손으로 단계별 풀이를 시키는 방법을 이 기능이 꺼져 있을 때 쓰는 대안(fallback)으로 소개합니다. Claude Opus 5.5, Sonnet 5.5 같은 최신 모델에서는 생각하는 기능에 맡기라고 하고, 답 안에 풀이를 따로 적어 달라는 요청은 거절될 수 있다고 적습니다. 단계를 하나하나 정해 주기보다 "충분히 생각해 봐" 같은 넓은 지시가 더 나은 경우가 많다고도 합니다.
- 자기 일관성: 문서에 나오지 않습니다. 여러 번 풀어 다수결하는 방법은 Claude 문서에서 찾지 못했습니다. 연구에서 나온 기법으로 알아 두면 됩니다.
원본 레슨 11-02도 같은 방향입니다. 답하기 전에 스스로 길게 생각하도록 만든 추론 모델에는 이 주문이 필요 없거나 오히려 해로울 수 있다고 적습니다. 아래 "더 깊이"의 스탠퍼드 강의는 한 걸음 더 나가, 요즘 모델은 예시 없이 지시만 잘 써도 비슷하거나 더 나은 결과가 나올 수 있다고 봅니다.
그렇다고 생각의 사슬을 몰라도 되는 건 아닙니다. 요즘 모델의 생각하는 기능도 답하기 전에 풀이할 자리를 따로 준다는 점에서 닮았습니다. 왜 풀이를 먼저 쓰면 잘 맞히는지 알면, 그 기능을 언제 켜고 얼마나 쓸지 판단하기도 쉬워집니다.
정리하면 이렇습니다. 먼저 지시를 구체적으로 씁니다. 형식이나 기준이 말로 잘 전해지지 않으면 서로 다른 예시를 몇 개 붙입니다. 풀이는 생각하는 기능이 있는 모델이면 그 기능에 맡기고, 없는 모델에서만 "단계별로 생각해 봐"를 붙입니다. 여러 번 풀어 다수결하는 방법은 틀리면 손해가 큰 일에만 씁니다.
따라 해 보기: 같은 질문을 두 가지로 물어보기
API 키 없이 채팅 창에서 해 볼 수 있습니다. 쓰는 AI(ChatGPT, Claude 등)에 아래 문제를 두 번 물어보세요. 한 번은 그대로, 한 번은 끝에 "단계별로 생각해 보세요."를 붙여서요.
저글러가 공 16개를 던집니다. 공의 절반은 골프공이고, 골프공의 절반은 파란색입니다. 파란 골프공은 몇 개일까요?
요즘 모델은 둘 다 맞힐 가능성이 높습니다(정답 4). 생각하는 기능이 켜진 모델은 한 줄을 붙이지 않아도 먼저 생각한 뒤 답합니다. 맞고 틀림보다 두 답의 모양이 어떻게 다른지 비교해 보세요.
프롬프트 두 개를 여러 질문에 나란히 돌려 보고 싶다면 오픈소스 평가 도구 promptfoo가 있습니다. 아래 설정은 실제 모델 대신 받은 글을 그대로 돌려주는 echo를 써서 키 없이 돌아갑니다. 비교 틀만 보여 주고 정확도는 재지 않습니다.
# promptfooconfig.yaml
providers:
  - echo
prompts:
  - "Q: {{question}} A:"
  - "Q: {{question}} A: Let's think step by step."
tests:
  - vars:
      question: "A juggler can juggle 16 balls. Half of the balls are golf balls, and half of the golf balls are blue. How many blue golf balls are there?"
    assert:
      - type: icontains
        value: "step by step"
PROMPTFOO_DISABLE_TELEMETRY=1 npx -y promptfoo@latest eval -c promptfooconfig.yaml --no-share
echo를 실제 모델로 바꾸고 검사를 contains: "4"로 바꾸면 진짜 정답률 비교가 됩니다(API 키 필요).
자주 묻는 질문
Q. 프롬프트 엔지니어링은 아직 필요한가요? 요령보다 원하는 것을 분명히 쓰는 일이 더 중요해졌습니다. 원본 레슨 11-01은 프롬프트 엔지니어링을 지시를 잘 쓰는 일로 정의하고, Claude 공식 문서도 최신 모델은 적힌 지시를 정확히 따르니 바라는 것을 분명히 적으라고 합니다.
Q. 견본은 몇 개가 좋나요? 원본 레슨 11-02와 Claude 공식 문서 모두 3~5개를 권합니다. 숫자보다 중요한 건 내용입니다. 실제 질문과 비슷하면서도, 예시끼리는 충분히 달라야 엉뚱한 패턴을 따라 하지 않습니다.
Q. "단계별로 생각해 봐"는 아무 질문에나 붙이면 되나요? 여러 단계 계산이나 판단이 필요한 질문에서 효과가 납니다. 단순한 사실 질문에서는 답만 길어집니다. Claude Opus 5.5, Sonnet 5.5처럼 생각하는 기능이 있는 모델은 이 한 줄 대신 그 기능에 맡기라는 것이 공식 권고입니다. 다른 회사 모델도 그 회사 문서를 먼저 확인하세요.
더 깊이: CoT 논문 세 편, 스탠퍼드 강의, 코드
생각의 사슬 논문. Wei 외, "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models"(arXiv 2201.11903, 2022년 1월). 초록의 주장은 세 가지입니다.
- 중간 풀이 단계를 쓰게 하면 복잡한 추론을 훨씬 잘합니다.
- 충분히 큰 모델에서는 풀이가 적힌 예시 몇 개만 프롬프트에 넣어도 이 능력이 나타납니다.
- 산술, 상식, 기호 추론에서 세 종류 대형 모델 모두 좋아졌습니다. 5,400억 매개변수 모델에 풀이 예시 8개만 주고 초등 수학 문장제 벤치마크(GSM8K)에서 당시 최고 성능을 냈습니다.
이 논문의 방식은 그림 1의 가운데 칸, 풀이가 있는 견본입니다.
"Let's think step by step" 논문. Kojima 외, "Large Language Models are Zero-Shot Reasoners"(arXiv 2205.11916, 2022년 5월, NeurIPS 2022). 견본 없이 답 앞에 "Let's think step by step" 한 줄만 붙이는 방식입니다(그림 1의 세 번째 칸). 같은 한 줄이 산술, 기호, 논리 과제에 두루 통했다고 보고합니다. 그림 2의 숫자가 이 초록에 있습니다. InstructGPT(text-davinci-002)에서 MultiArith 17.7% → 78.7%, GSM8K 10.4% → 40.7%입니다.
자기 일관성 논문. Wang 외, "Self-Consistency Improves Chain of Thought Reasoning in Language Models"(arXiv 2203.11171, 2022년 3월, ICLR 2023). 가장 그럴듯한 풀이 하나만 고르는 대신 서로 다른 풀이를 여럿 뽑고, 가장 많이 나온 최종 답을 고릅니다. 어려운 문제일수록 정답에 이르는 길이 여러 갈래라는 직관입니다. 초록은 GSM8K +17.9%, SVAMP +11.0%, AQuA +12.2% 등의 향상을 보고합니다.
Stanford CME295 3강 "Prompting"(1:07:07). 프롬프트 구조에는 정해진 이론이 없지만, 맥락·지시·입력·제약 네 부분으로 보는 게 좋은 사고 틀이라고 설명합니다(1:11:45). 제로샷과 퓨샷을 소개한 뒤 이렇게 덧붙입니다(1:16:49). 퓨샷이 대체로 낫지만 늘 그렇지는 않고, 요즘 추론 가능한 모델은 지시를 잘 쓰면 예시를 준 것과 비슷하거나 더 낫다는 것입니다. 예시가 모델을 몇 가지 본보기 안에 가둘 수 있다는 이유를 들고, 이 연구는 아직 진행 중이라고 덧붙입니다.
생각의 사슬(1:18:47)에서는 쓸모를 하나 더 꼽습니다. 풀이가 읽을 수 있는 글이라 디버깅이 쉽다는 것입니다(1:20:12). 풀이에 엉뚱한 연도가 나오면, 문맥에 날짜를 잘못 넣었다는 걸 바로 알 수 있습니다. 글자가 늘어 느려지기는 하지만 대체로 감수할 만하다고 봅니다. 자기 일관성(1:21:38)은 여러 번 뽑아 최종 답만 다수결하는 방법으로 설명합니다. 답을 꺼내기 쉽게 "답을 맨 끝에 쓰라"고 시키라는 팁과, 여러 번 부르는 일은 동시에 돌릴 수 있어 기다리는 시간이 가장 느린 한 번 수준이라는 설명도 나옵니다.
Stanford CS230 8강 "Agents, Prompts, and RAG"(Kian Katanforoosh, 17:51). 기본 원칙으로 "이 문서 요약해"를 "재생에너지 과학 논문 10쪽을 정책 결정자를 위해 핵심 발견 중심 다섯 줄로"처럼 독자·형식·초점을 정한 지시로 바꾸는 예를 듭니다(21:41). 퓨샷 예로는 "제품은 괜찮은데 기대보다는 아쉬웠다"라는 리뷰의 어조 분류를 듭니다(27:53). 업계마다 기준이 주관적이라, 라벨을 붙인 예시 세 개로 원하는 기준을 맞춘다는 설명입니다. 프롬프트를 고친 뒤에는 처음엔 사람이 직접 보고, 이후 promptfoo 같은 도구와 다른 모델을 심판으로 쓰는 평가로 넘어가라고 권합니다(38:00).
코드. 원본 레슨 11-01의 예제는 API 키 없이 돌아갑니다(모델 자리는 가짜). 프롬프트 패턴 10개를 데이터로 두고 채우는 함수와 길이·키워드·형식을 검사하는 채점기를 볼 수 있습니다. 11-02의 예제는 OpenAI API 키가 필요합니다. 실제 모델로 돌린다면 그림 4의 마침표 문제부터 고쳐야 숫자가 제대로 나옵니다. promptfoo(MIT)는 프롬프트와 모델을 나란히 평가하는 도구이고, DSPy(MIT)는 ChainOfThought, majority 같은 모듈로 같은 기법을 코드로 짜 맞춥니다.
다음 화 예고. 프롬프트 하나로 안 되는 일은 여러 단계로 나눕니다. 4화에서는 에이전트를 만들 때 자주 쓰는 워크플로 패턴을 다룹니다.
원본: rohitg00/ai-engineering-from-scratch (MIT, © 2026 Rohit Ghumare). 이 글은 원문을 바탕으로 직접 정리하고 재구성했습니다.
출처
- rohitg00/ai-engineering-from-scratch, 11-01 Prompt Engineering: https://github.com/rohitg00/ai-engineering-from-scratch/tree/main/phases/11-llm-engineering/01-prompt-engineering
- rohitg00/ai-engineering-from-scratch, 11-02 Few-Shot, Chain-of-Thought, Tree-of-Thought: https://github.com/rohitg00/ai-engineering-from-scratch/tree/main/phases/11-llm-engineering/02-few-shot-cot
- Wei et al., Chain-of-Thought Prompting (arXiv 2201.11903): https://arxiv.org/abs/2201.11903
- Kojima et al., Large Language Models are Zero-Shot Reasoners (arXiv 2205.11916): https://arxiv.org/abs/2205.11916
- Wang et al., Self-Consistency (arXiv 2203.11171): https://arxiv.org/abs/2203.11171
- Stanford CME295 Lecture 3, Prompting 1:07:07 (영어 자막 확인): https://www.youtube.com/watch?v=Q5baLehv5So&t=1h7m7s
- Stanford CS230 Lecture 8, Agents, Prompts, and RAG, 17:51 (영어 자막 확인): https://www.youtube.com/watch?v=k1njvbBmfsw&t=17m51s
- promptfoo/promptfoo (MIT): https://github.com/promptfoo/promptfoo
- stanfordnlp/dspy (MIT): https://github.com/stanfordnlp/dspy
- Claude 공식 문서, Prompting best practices (2026-10-12 확인): https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/claude-prompting-best-practices
'AI > Engineering' 카테고리의 다른 글
| MCP 서버 만들기: Python SDK로 함수 세 개, 26줄 첫 MCP 서버 (직접 짜면 400줄인 이유까지) (0) | 2026.10.20 |
|---|---|
| MCP란? AI 앱과 도구를 잇는 표준 규격 MCP 구조 쉽게 정리 (호스트·클라이언트·서버, 도구·리소스·프롬프트) (0) | 2026.10.18 |
| 모든 AI 일을 에이전트로 시켜야 할까? 워크플로와 에이전트의 차이, 워크플로 패턴 5가지 쉽게 정리 (0) | 2026.10.15 |
| AI 에이전트는 왜 몇 번씩 다시 시도할까? ReAct 루프 쉽게 정리 (생각·행동·관찰) (0) | 2026.10.06 |
| Claude Code는 어떻게 파일을 고칠까? AI 에이전트 원리 쉽게 정리 (LLM·루프·도구) (0) | 2026.10.01 |