요약. AI에게 여러 단계짜리 일을 시키는 방법은 두 가지입니다. 사람이 순서를 미리 정해 두는 워크플로와, 모델이 다음에 할 일을 스스로 정하는 에이전트입니다. Anthropic은 가장 단순한 방법부터 쓰고, 단계를 미리 알 수 없을 때만 에이전트를 쓰라고 권합니다. 워크플로에는 자주 쓰는 모양이 다섯 가지 있습니다. 앞 단계 결과를 다음 단계로 넘기는 체이닝, 입력 종류에 따라 담당을 나누는 라우팅, 여러 호출을 한꺼번에 돌리는 병렬화, 지휘 모델이 일을 나눠 주는 오케스트레이터-워커, 쓰고 평가하고 고치기를 반복하는 평가자-최적화입니다.
3화에서 이어지는 질문: 프롬프트 하나로 안 되는 일
3화 "단계별로 생각해 봐"에서는 모델에게 한 번 잘 묻는 법을 다뤘습니다. 그런데 실제 일은 한 번 묻고 끝나지 않는 경우가 많습니다. 회의록을 정리하고, 할 일을 뽑고, 담당자별로 메시지를 쓰는 일처럼요.
이런 일을 AI에게 맡길 때 요즘은 "에이전트를 만들자"는 말부터 나옵니다. 1화에서 본 것처럼 에이전트는 생각하고, 도구를 쓰고, 결과를 보고, 다시 생각하는 루프를 돕니다. 똑똑하지만 몇 바퀴를 돌지, 비용이 얼마나 들지 미리 알 수 없습니다.
이번 화의 질문은 이것입니다. 여러 단계짜리 일은 모두 에이전트에게 맡겨야 할까요?
워크플로와 에이전트의 차이: 누가 순서를 정하나
원본 레슨 14-12 Anthropic's Workflow Patterns은 Anthropic의 글 "Building Effective Agents"를 바탕으로 둘을 이렇게 나눕니다.
- 워크플로: 사람이 미리 짜 둔 순서대로 모델과 도구를 부릅니다. 순서도를 사람이 그립니다.
- 에이전트: 모델이 다음에 무엇을 할지, 어떤 도구를 쓸지 스스로 정합니다. 순서도를 모델이 그립니다.
주방에 비유하면 워크플로는 공정표가 붙은 주방입니다. 손질, 조리, 담기 순서가 정해져 있어 빠르고, 재료비가 예측되고, 문제가 생기면 몇 번째 단계인지 바로 압니다. 에이전트는 "알아서 맛있게"라고 셰프에게 맡기는 쪽입니다. 처음 보는 주문도 해내지만, 몇 단계가 걸릴지 미리 모릅니다.
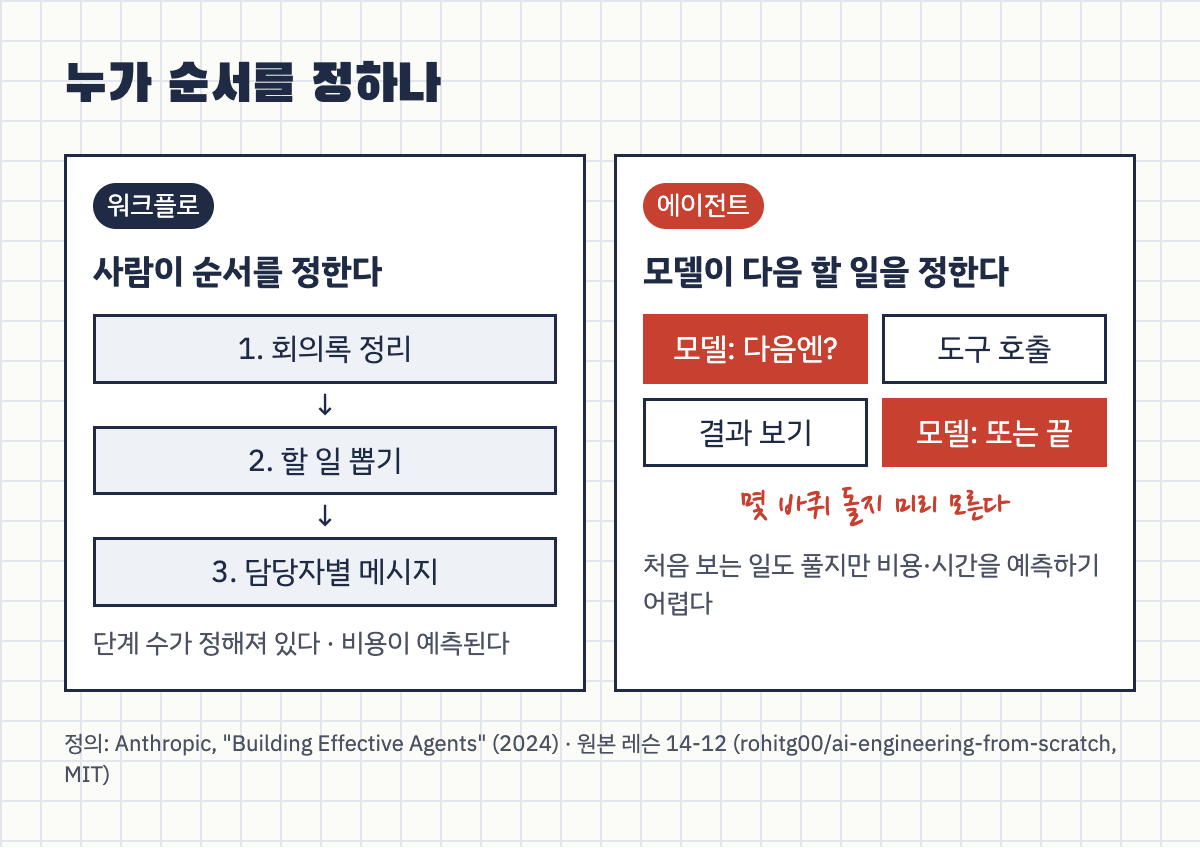
그림 1. 차이는 순서를 누가 정하느냐입니다.
어느 쪽이 더 낫다는 이야기는 아닙니다. 레슨은 워크플로가 싸고 빠르고 고치기 쉬운 대신, 에이전트는 정해진 답이 없는 일을 풀 수 있지만 왜 실패했는지 따지기 어렵다고 정리합니다. Anthropic 글의 권고는 분명합니다. 가장 단순한 방법부터 쓰고, 그걸로 부족할 때만 복잡하게 만들라는 것입니다. 많은 경우 검색 결과와 예시를 곁들인 호출 한 번으로 충분하다고도 적습니다.
워크플로 패턴 다섯 가지
Anthropic 글은 실제로 자주 본 워크플로를 다섯 가지 모양으로 정리합니다. 다섯 가지 모두 바탕은 같습니다. 검색, 도구, 메모리를 붙인 언어 모델 하나입니다. 2화에서 본 함수 호출이 여기서 "도구"입니다.
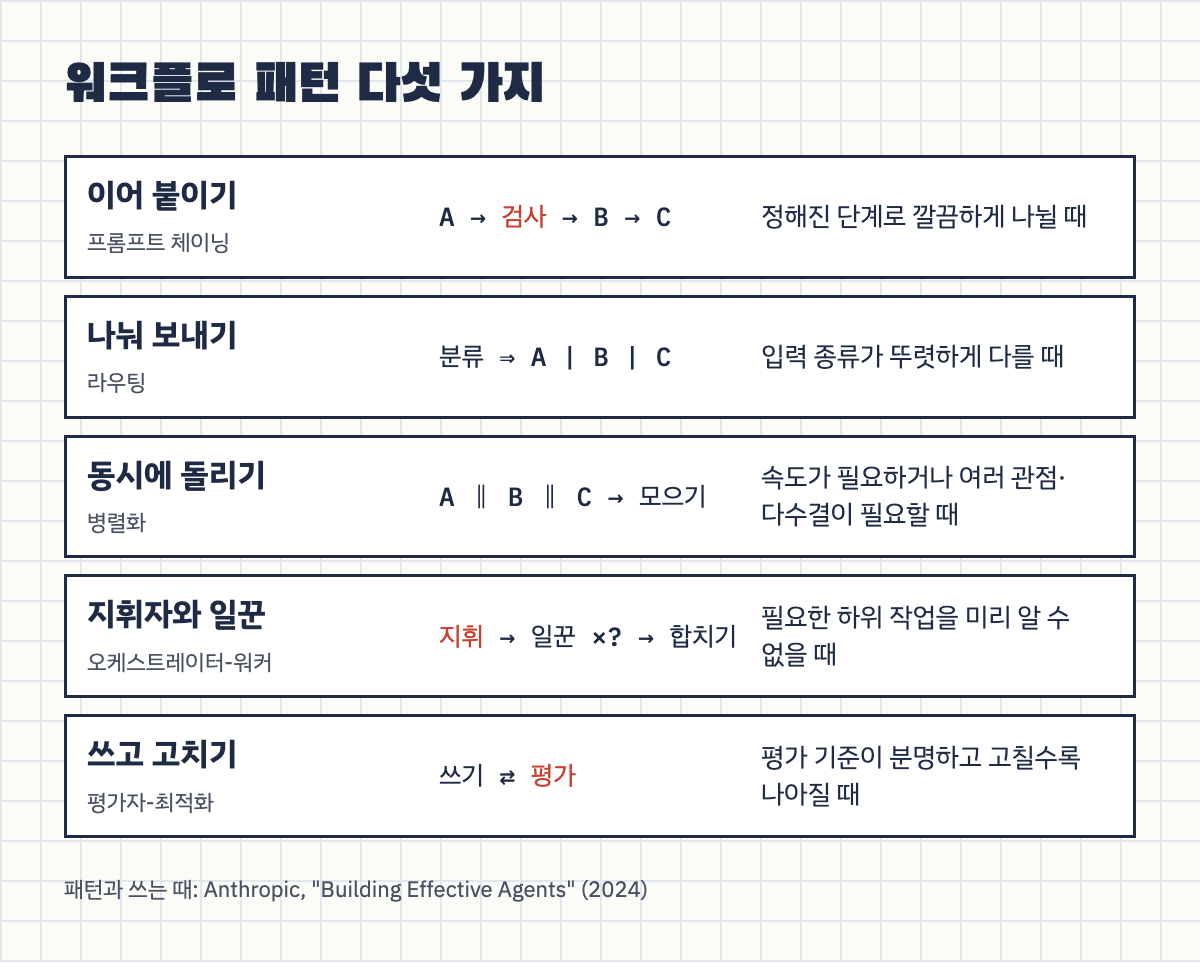
그림 2. 다섯 패턴과 각각 언제 쓰는지.
1. 체이닝(프롬프트 체이닝): 이어 붙이기. 첫 호출의 답이 다음 호출의 입력이 됩니다. 마케팅 문구를 쓰고 그 문구를 번역하는 식입니다. 단계 사이에 코드로 검사하는 문을 둘 수 있습니다. 예를 들어 개요를 쓴 뒤 "필요한 항목이 다 들어갔나"를 확인하고 나서 본문으로 넘어갑니다. 일이 정해진 단계로 깔끔하게 나뉠 때 씁니다. 시간은 더 들지만 단계마다 쉬운 일만 시키니 정확해집니다.
2. 라우팅: 나눠 보내기. 먼저 입력을 분류하고, 종류마다 다른 처리로 보냅니다. 고객 문의를 환불, 오류 신고, 영업 문의로 나눠 각각 다른 지시문으로 답하는 식입니다. 쉬운 질문은 작고 싼 모델로, 어려운 질문은 큰 모델로 보내는 것도 라우팅입니다. 종류가 뚜렷하고 분류를 정확히 할 수 있을 때 씁니다.
3. 병렬화: 동시에 돌리기. 두 가지 모양이 있습니다. 일을 독립된 조각으로 나눠 동시에 맡기는 나눠 맡기기와, 같은 일을 여러 번 시켜 결과를 모으는 투표입니다. 투표는 3화에서 본 "여러 번 풀게 하고 다수결"과 같은 생각입니다. 속도가 필요하거나, 여러 관점으로 봐야 믿을 수 있을 때 씁니다. 코드 리뷰를 여러 번 돌려 취약점을 찾는 예가 글에 나옵니다.
4. 오케스트레이터-워커: 지휘자와 일꾼. 지휘하는 모델이 일을 받아 하위 작업으로 쪼개고, 일꾼 모델들에게 나눠 준 뒤 결과를 합칩니다. 병렬화와 다른 점은 쪼개는 방식이 미리 정해져 있지 않다는 것입니다. 여러 파일을 한꺼번에 고쳐야 하는 코딩처럼, 어떤 하위 작업이 필요할지 미리 알 수 없을 때 씁니다.
5. 평가자-최적화: 쓰고 고치기. 한 모델이 답을 쓰면 다른 모델이 평가하고 피드백을 줍니다. 통과할 때까지 반복합니다. 평가 기준이 분명하고, 고칠수록 실제로 나아질 때 씁니다. 글에는 문학 번역을 다듬는 예가 나옵니다.
레슨 코드로 돌려 보면: 이름과 실제가 다른 곳
레슨 예제는 다섯 패턴을 각각 짧은 함수 하나로 만들고, 정해진 답을 돌려주는 가짜 모델로 흐름을 보여 줍니다. API 키 없이 바로 돌아갑니다. 다섯 패턴을 다 돌리는 데 모델 호출은 모두 20번입니다.
그런데 코드를 읽어 보면 두 군데가 설명과 다릅니다.
첫째, 병렬화 코드가 실제로는 동시에 돌지 않습니다. 레슨 설명은 "여러 호출을 동시에"라고 하는데, 코드는 다섯 번을 차례로 부릅니다. 호출 한 번에 1초가 걸리도록 가짜 모델을 바꿔 재 보니 레슨 코드는 5.0초, 동시에 부르도록 고친 코드는 1.0초가 걸렸습니다. 투표 결과(예 3표, 아니오 2표)는 같습니다.
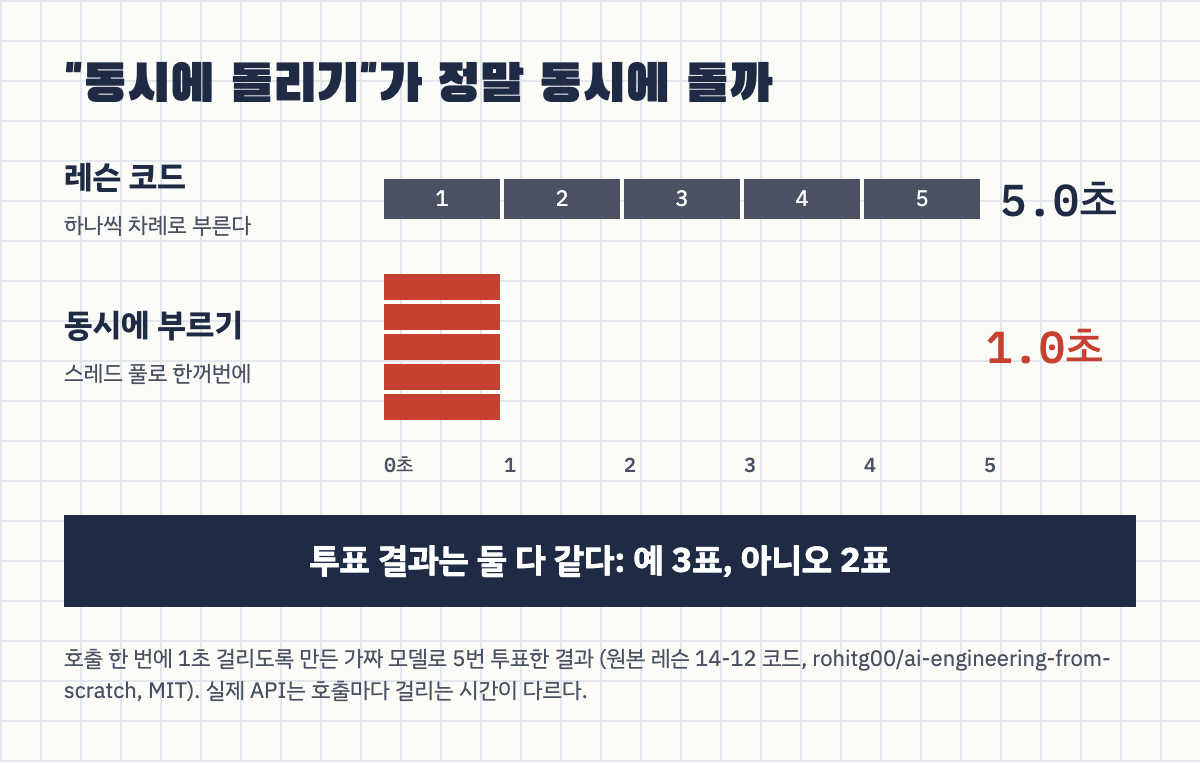
그림 3. 가짜 모델, 호출당 1초로 고정한 조건입니다. 실제 API는 호출마다 걸리는 시간이 다릅니다.
둘째, 오케스트레이터-워커 코드에는 지휘하는 모델이 없습니다. 일꾼마다 "작업에 python이라는 단어가 있으면 실행" 같은 조건이 붙어 있고, 그 조건으로 일꾼을 고릅니다. 설명대로라면 지휘 모델이 작업을 보고 일을 나눠야 합니다. 레슨 코드는 단순화한 버전으로 보고, 원래 모양은 아래 "더 깊이"의 Anthropic 예제 코드에서 확인하는 게 좋습니다.
패턴 이름만 보고 코드를 가져다 쓰면 이런 차이를 놓치기 쉽습니다. "병렬"이라고 적혀 있어도 정말 동시에 도는지, "지휘자"가 정말 판단을 하는지 한 번은 확인해야 합니다.
쓰고 고치기는 어떻게 도나
다섯 패턴 중 평가자-최적화는 레슨 예제 출력으로 보면 이해가 쉽습니다. 과제는 "ReAct를 한 줄로 요약하기"입니다.
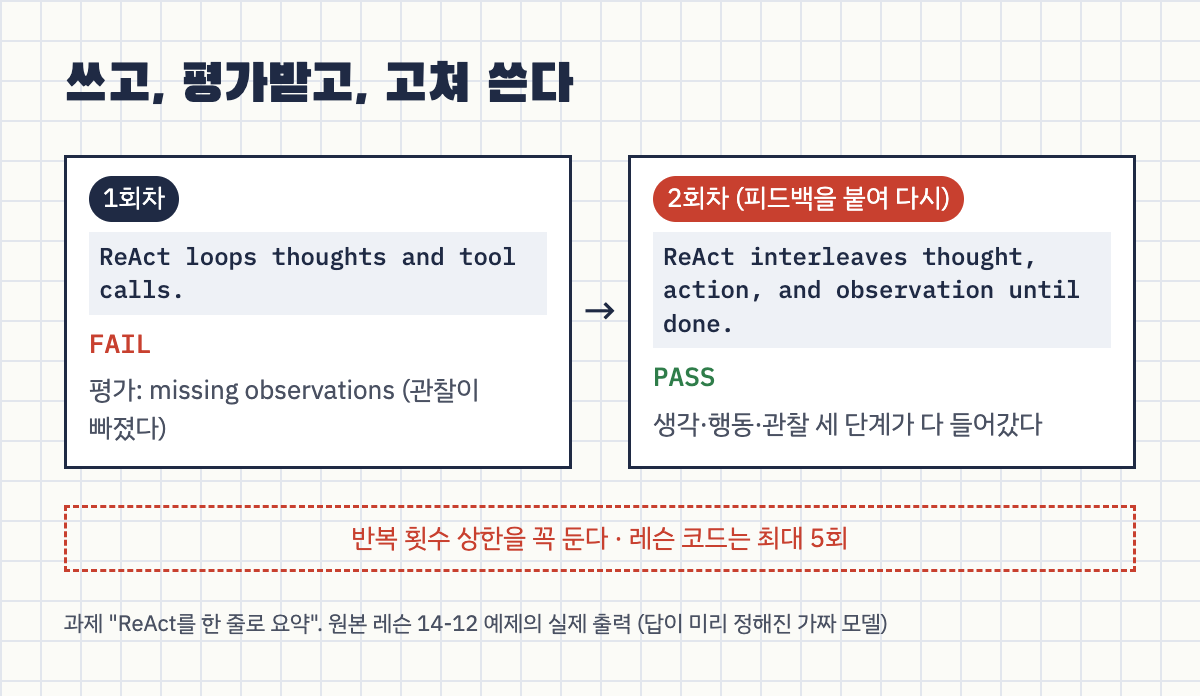
그림 4. 레슨 예제의 실제 출력입니다. 가짜 모델이라 답은 미리 정해져 있습니다.
1회차 답은 "생각과 도구 호출을 반복한다"였고, 평가에서 "관찰(observation)이 빠졌다"는 이유로 떨어집니다. 이 피드백을 붙여 다시 쓰게 하자 "생각, 행동, 관찰을 끝날 때까지 번갈아 한다"가 나오고 통과합니다. 1화에서 본 ReAct 루프의 세 단계가 그대로 들어간 답입니다.
여기서 꼭 챙길 것은 멈춤 조건입니다. 레슨이 함께 주는 패턴 선택 지침은 반복 횟수 상한이 없는 평가 루프를 금지합니다. 평가가 계속 떨어뜨리면 끝없이 돌 수 있기 때문입니다.
에이전트는 언제 쓸까: 네 가지 질문
그럼 에이전트는 언제 쓸까요? Anthropic 글을 함께 쓴 Barry Zhang은 강연 "How We Build Effective Agents"에서 네 가지를 먼저 따져 보라고 합니다.
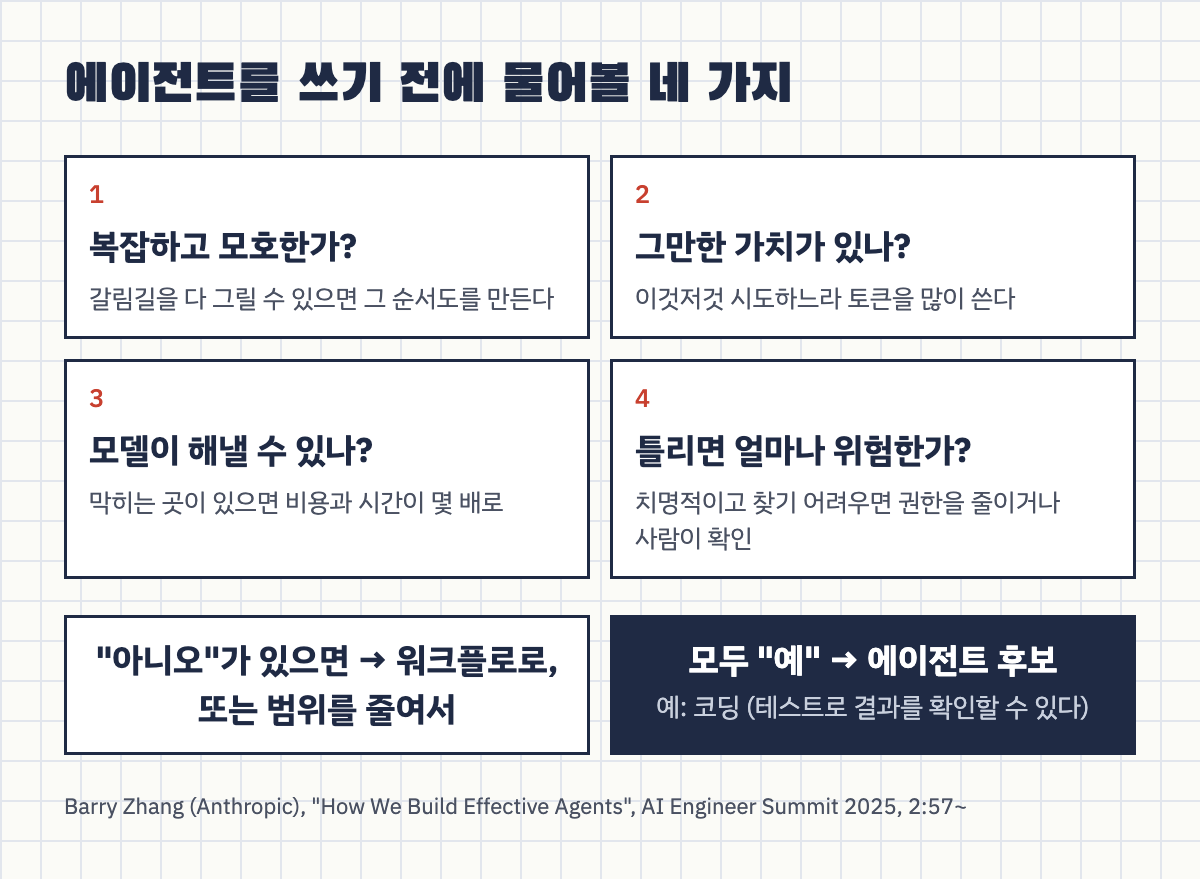
그림 5. Barry Zhang 강연(AI Engineer Summit 2025)의 체크리스트를 정리했습니다.
- 일이 복잡하고 모호한가. 갈림길을 전부 그릴 수 있으면 그냥 그 순서도를 만드는 게 싸고 다루기 쉽습니다.
- 그만한 가치가 있나. 에이전트는 이것저것 시도하느라 토큰을 많이 씁니다. 건당 예산이 아주 작은 대량 고객 응대라면 흔한 경우만 워크플로로 처리하는 편이 낫다고 합니다.
- 모델이 해낼 수 있나. 코딩 에이전트라면 코드를 쓰고, 디버깅하고, 실수에서 회복할 수 있어야 합니다. 막히는 곳이 있으면 비용과 시간이 몇 배로 늘어납니다.
- 틀렸을 때 비용과 발견이 어떤가. 실수가 치명적이고 찾기 어렵다면 맡기기 어렵습니다. 읽기 전용 권한이나 사람 확인으로 줄일 수 있지만, 그만큼 맡길 수 있는 일도 줄어듭니다.
그는 코딩을 좋은 예로 듭니다. 설계 문서에서 코드 변경까지 가는 길은 복잡하고, 좋은 코드는 가치가 크고, 결과를 테스트로 검증할 수 있기 때문입니다. 원본 레슨도 비슷하게 정리합니다. 단계를 셀 수 있거나, 비용 상한이 필요하거나, 감사 담당자가 흐름을 읽어야 하는 일은 워크플로가 낫습니다. 다음 단계가 앞 결과에 달린 조사나, 아직 정답 흐름을 모르는 새 영역은 에이전트가 낫습니다.
모델이 빨리 바뀌어도 남는 것
요즘은 모델이 바뀌는 속도가 너무 빨라서, 지난달에 익힌 요령이 이번 달엔 쓸모없어지는 일이 흔합니다. 3화에서 본 "단계별로 생각해 봐"도 최신 Claude 모델에서는 대안으로 밀려났습니다.
그래서 이번 화에서는 특정 요령보다 오래 갈 판단 기준을 남겨 두려 합니다. "순서를 미리 알 수 있는가"라는 질문은 모델이 바뀌어도 그대로입니다. Barry Zhang도 처음부터 복잡하게 만들면 고치는 속도가 떨어진다며, 모델과 도구와 지시문이라는 기본 요소부터 다듬으라고 합니다. 단순하게 만들어 두면 더 나은 모델이 나왔을 때 갈아 끼우기도 쉽습니다.
따라 해 보기: 한 번에 시키기 vs 나눠 시키기
1. 채팅 창에서 체이닝 해 보기 (API 키 없이). 긴 글 하나를 골라 두 가지로 시켜 보세요.
- 한 번에: "이 글을 세 줄로 요약하고, 요약을 바탕으로 제목 다섯 개를 지어 줘."
- 나눠서: 먼저 "이 글을 세 줄로 요약해 줘." 답을 확인하고 고친 뒤, 새 대화에서 "이 요약으로 제목 다섯 개를 지어 줘."
두 번째가 체이닝입니다. 중간에 요약을 사람이 확인한 게 "단계 사이의 검사 문"입니다. 어느 쪽이 더 나았는지보다, 중간 결과를 확인할 수 있다는 게 어떤 차이를 만드는지 보세요.
2. 레슨 코드 돌려 보기 (Python만 있으면 됨). 원본 레슨 예제는 외부 패키지 없이 돌아갑니다.
curl -O https://raw.githubusercontent.com/rohitg00/ai-engineering-from-scratch/main/phases/14-agent-engineering/12-anthropic-workflow-patterns/code/main.py
python3 main.py
다섯 패턴의 흐름이 차례로 출력됩니다. 출력을 본 뒤 parallel_vote 함수를 열어, 정말 동시에 부르는지 직접 확인해 보세요.
이런 데 쓸 수 있다
- 문의 메일 분류 후 담당별 답변 초안 (라우팅). 계정, 결제, 오류 신고, 기타로 나누고 종류마다 다른 지시문으로 초안을 씁니다. 분류가 애매하면 사람에게 넘기는 기준을 함께 둡니다.
- 회의록에서 할 일 뽑기 (체이닝 + 검사). 회의록 정리 → 할 일 추출 → 담당자별 메시지. 중간에 "할 일마다 담당자와 기한이 있나"를 코드로 검사합니다.
- 여러 관점 코드 리뷰 (병렬화 + 평가자-최적화). 보안, 가독성, 테스트 관점을 동시에 돌려 합치고, 기준을 통과할 때까지 정해진 횟수만큼만 고쳐 쓰게 합니다.
자주 묻는 질문
Q. 워크플로와 에이전트는 어떻게 구분하나요? 순서를 누가 정하는지 보면 됩니다. Anthropic "Building Effective Agents"는 미리 정한 코드 경로로 모델과 도구를 엮으면 워크플로, 모델이 자기 과정과 도구 사용을 스스로 정하면 에이전트로 나눕니다.
Q. 멀티에이전트 프레임워크를 꼭 써야 하나요? 처음에는 필요 없는 경우가 많습니다. Anthropic 글은 프레임워크가 실제 프롬프트와 응답을 가려 디버깅을 어렵게 할 수 있으니 API를 직접 부르는 것부터 시작하라고 권합니다. 원본 레슨도 3단계 체이닝에 프레임워크를 쓰는 것을 과설계로 봅니다.
Q. 일꾼 모델 여러 개를 쓰면 멀티에이전트인가요? 꼭 그렇지는 않습니다. 원본 레슨의 패턴 선택 지침은 일꾼 셋을 둔 오케스트레이터-워커를 "멀티에이전트"라고 부르지 말라고 합니다. 일꾼은 스스로 판단하며 도는 에이전트가 아니라 한 번씩 부르는 모델 호출이기 때문입니다.
더 깊이: Anthropic 글, 강연 두 편, Self-Refine 논문, 코드
Anthropic "Building Effective Agents" (Erik Schluntz, Barry Zhang, 2024-12-19). 원문. 이번 화의 주 출처입니다. 패턴마다 언제 쓰는지를 이렇게 적습니다. 체이닝은 정해진 하위 작업으로 깔끔하게 나뉠 때, 시간을 정확도와 맞바꾸는 방법입니다. 라우팅은 종류가 뚜렷하고 분류가 정확할 때 씁니다. 병렬화는 나눠서 빨라지거나 여러 관점이 필요할 때 쓰고, 안전 검사를 본 답변과 별도 호출로 돌리는 예도 듭니다. 오케스트레이터-워커는 필요한 하위 작업을 미리 알 수 없을 때, 평가자-최적화는 평가 기준이 분명하고 반복 개선의 효과가 측정될 때 씁니다. 에이전트는 시간과 비용을 성능과 맞바꾼다고 보고, 에이전트를 만들 때의 원칙 세 가지로 단순함, 투명함(계획 단계를 드러내기), 도구 설명과 테스트를 꼽습니다. 부록은 고객 지원과 코딩을 에이전트가 특히 잘 맞는 사례로 듭니다. 코딩은 자동 테스트로 결과를 검증할 수 있기 때문입니다.
Barry Zhang, "How We Build Effective Agents" (AI Engineer Summit 2025, 15분). 영상. 핵심은 세 가지입니다(0:52). 모든 일에 에이전트를 만들지 말 것, 단순하게 유지할 것, 에이전트 입장에서 생각할 것. 체크리스트는 2:57부터입니다. 건당 예산이 10센트 정도인 대량 고객 지원이라면 3만~5만 토큰밖에 쓸 수 없으니 흔한 경우만 워크플로로 처리하라는 예를 듭니다. 5:38에서는 에이전트를 "루프 안에서 도구를 쓰는 모델"로 정의하고, 환경·도구·시스템 프롬프트 세 가지만 먼저 다듬으라고 합니다. 8:03의 "에이전트처럼 생각하기"에서는 매 단계 모델이 아는 건 컨텍스트에 들어 있는 것뿐이니, 시스템 프롬프트와 도구 설명을 Claude에게 보여 주고 어디가 모호한지 물어보라고 권합니다.
Stanford Webinar "Agentic AI" (Insop Song). 영상. 설명란 챕터 시각이 실제와 어긋나 자막 기준으로 적습니다. 31:53에서 사람이 프롬프트를 미리 쪼개 잇는 방식(체이닝)과 모델에게 계획을 세우게 하는 방식을 대비합니다. 워크플로와 에이전트를 가르는 "누가 쪼개느냐"와 같은 이야기입니다. 33:15의 고객 지원 예는 환불 문의를 규정 확인, 주문 확인, 제품 확인으로 나누고 마지막은 사람이 승인합니다. 39:00의 "디자인 패턴"은 Anthropic의 다섯 가지와 다른 분류(계획, 반성, 도구 사용, 멀티에이전트)입니다. 이 중 반성(reflection)은 코드를 검토해 피드백을 받고 그 피드백으로 다시 고쳐 쓰는 예로 설명하는데, 평가자-최적화와 같은 모양입니다.
Self-Refine 논문. Madaan 외, "Self-Refine: Iterative Refinement with Self-Feedback"(arXiv 2303.17651, 2023년 3월). 같은 모델 하나가 초안을 쓰고, 스스로 피드백을 주고, 그 피드백으로 고치기를 반복합니다. 추가 학습이 필요 없습니다. 초록에 따르면 대화 응답부터 수학 추론까지 7개 과제에서 GPT-3.5, ChatGPT, GPT-4 모두 한 번에 쓴 답보다 선호됐고, 과제 성능이 평균 약 20%p 올랐습니다. Anthropic 글의 평가자-최적화는 쓰는 모델과 평가하는 모델을 나눈다는 점이 다르고, 원본 레슨은 평가자-최적화를 Self-Refine의 일반형으로 봅니다.
코드. 원본 레슨 14-12의 code/main.py는 표준 라이브러리만으로 다섯 패턴을 보여 줍니다(위 "따라 해 보기"). 실제 모델로 돌리는 참조 구현은 anthropics/claude-cookbooks의 patterns/agents(MIT)에 있습니다. basic_workflows 노트북의 parallel()은 ThreadPoolExecutor로 실제로 동시에 부르고, route()는 분류 전에 이유부터 쓰게 한 뒤 선택을 XML 태그로 받습니다. 3화의 생각의 사슬을 라우팅 판단에 쓴 셈입니다. orchestrator_workers 노트북은 지휘 모델이 입력을 보고 작업 목록을 만들고, 작업마다 일꾼 모델을 부릅니다. 노트북은 Anthropic API 키가 있어야 돌아가고 요금이 듭니다.
다음 화 예고. 1막은 여기까지입니다. 에이전트가 무엇이고(0화), 어떻게 돌고(1화), 도구를 어떻게 쓰고(2화), 어떻게 말을 걸고(3화), 일을 어떻게 나누는지(4화) 봤습니다. 2막은 에이전트를 바깥세상과 연결하는 이야기입니다. 5화에서는 도구를 연결하는 표준 규격인 MCP의 구조를 다룹니다.
원본: rohitg00/ai-engineering-from-scratch (MIT, © 2026 Rohit Ghumare). 이 글은 원문을 바탕으로 직접 정리하고 재구성했습니다.
출처
- rohitg00/ai-engineering-from-scratch, 14-12 Anthropic's Workflow Patterns: https://github.com/rohitg00/ai-engineering-from-scratch/tree/main/phases/14-agent-engineering/12-anthropic-workflow-patterns
- Anthropic, Building Effective Agents (2024-12-19): https://www.anthropic.com/research/building-effective-agents
- Barry Zhang, How We Build Effective Agents (AI Engineer Summit 2025, 영어 자막 확인): https://www.youtube.com/watch?v=D7_ipDqhtwk
- Stanford Webinar, Agentic AI (Insop Song), 31:53 (영어 자막 확인): https://www.youtube.com/watch?v=kJLiOGle3Lw&t=31m53s
- Madaan et al., Self-Refine (arXiv 2303.17651): https://arxiv.org/abs/2303.17651
- anthropics/claude-cookbooks, patterns/agents (MIT): https://github.com/anthropics/claude-cookbooks/tree/main/patterns/agents
'AI > Engineering' 카테고리의 다른 글
| MCP 서버 만들기: Python SDK로 함수 세 개, 26줄 첫 MCP 서버 (직접 짜면 400줄인 이유까지) (0) | 2026.10.20 |
|---|---|
| MCP란? AI 앱과 도구를 잇는 표준 규격 MCP 구조 쉽게 정리 (호스트·클라이언트·서버, 도구·리소스·프롬프트) (0) | 2026.10.18 |
| AI에게 "단계별로 생각해 봐"라고 하면 정말 더 잘할까? 프롬프트 기법 쉽게 정리 (퓨샷, 생각의 사슬) (0) | 2026.10.12 |
| AI 에이전트는 왜 몇 번씩 다시 시도할까? ReAct 루프 쉽게 정리 (생각·행동·관찰) (0) | 2026.10.06 |
| Claude Code는 어떻게 파일을 고칠까? AI 에이전트 원리 쉽게 정리 (LLM·루프·도구) (0) | 2026.10.01 |