요약. 언어 모델은 글자만 내놓습니다. 계산기나 날씨 API를 직접 누르지 못합니다. 대신 "이 도구를 이 값으로 불러 달라"는 정해진 형식의 요청을 쓰고, 실제 실행은 모델 바깥의 프로그램이 합니다. 결과는 다시 모델에게 돌아갑니다. 이 약속을 함수 호출(도구 호출) 이라고 부르고, 설명 → 결정 → 실행 → 관찰 네 단계로 돕니다.
1화에서 이어지는 질문: 에이전트는 어떻게 도구를 쓸까
1화 "AI 에이전트는 왜 몇 번씩 다시 시도할까?"에서는 에이전트가 생각하고, 행동하고, 결과를 관찰하는 고리를 봤습니다. 그런데 "행동"은 "도구를 부른다" 한 줄로 넘어갔습니다.
그런데 언어 모델은 글자를 이어 쓰는 프로그램입니다. 0화에서 본 Claude Code는 어떻게 파일을 읽고 명령을 실행할까요? 이번 화는 그 연결 부분을 엽니다.
언어 모델은 글자만 낸다
원본 레슨 13-01 The Tool Interface는 문제를 이렇게 정리합니다. 모델이 내놓는 것은 다음에 올 글자(토큰)의 확률뿐입니다. "지금 서울 날씨 어때?"라고 물으면 그럴듯한 문장은 쓰지만, 날씨 서비스에 접속하지는 못합니다.
그래서 역할을 나눕니다. 모델은 "무엇을 부를지"를 글자로 쓰고, 모델을 감싼 프로그램이 그 요청을 받아 진짜로 실행합니다. 레슨은 이 프로그램을 호스트라고 부릅니다. 에이전트 앱, Claude Code, 직접 짠 스크립트가 모두 호스트입니다.
함수 호출이란? 메뉴판과 주문서
식당에 비유하면 쉽습니다. 손님은 주방에 들어가지 못하고, 메뉴판을 보고 주문서를 씁니다. 직원이 주문서를 확인해 주방에 넘기고 요리를 가져다줍니다.
함수 호출도 같습니다. 호스트가 모델에게 도구 목록을 줍니다. 도구마다 이름, 언제 쓰는지에 대한 설명, 받는 값의 형식(스키마)이 적혀 있습니다. 모델은 필요하다고 판단하면 도구 호출을 씁니다. 도구 이름과 값을 정해진 칸에 채운 요청입니다.
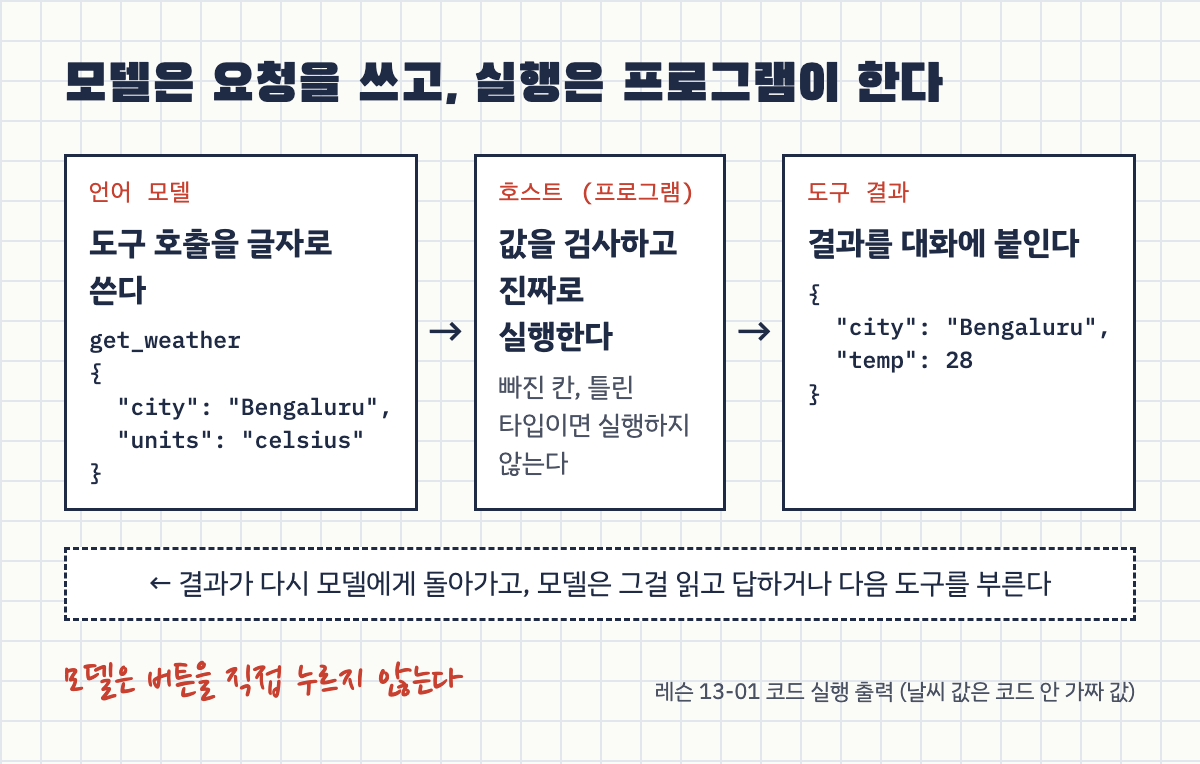
그림 1. 모델은 요청을 쓰고, 실행은 호스트가 합니다. 원본 레슨 코드를 실행한 출력입니다(날씨 값은 코드 안의 가짜 값).
Claude API 공식 문서 "Tool use with Claude"도 같은 순서로 설명합니다. Claude가 tool_use 블록으로 도구 이름과 값을 돌려주면, 앱이 실행하고 tool_result로 결과를 보냅니다.
도구 호출 4단계: 설명 → 결정 → 실행 → 관찰
원본 레슨 13-01 The Tool Interface는 이 과정을 네 단계로 나누고, 단계마다 누가 맡는지 짚습니다.
- 설명: 호스트가 도구 목록을 알려 줍니다.
- 결정: 모델이 바로 답할지, 어떤 도구를 어떤 값으로 부를지 고릅니다. 결과와 짝짓도록 호출마다 번호(id)가 붙습니다.
- 실행: 호스트가 값을 검사한 뒤 실제로 실행합니다.
- 관찰: 호스트가 결과를 대화에 붙여 모델을 다시 부릅니다. 모델이 더 부를 도구가 없거나 횟수 상한에 닿을 때까지 반복합니다.
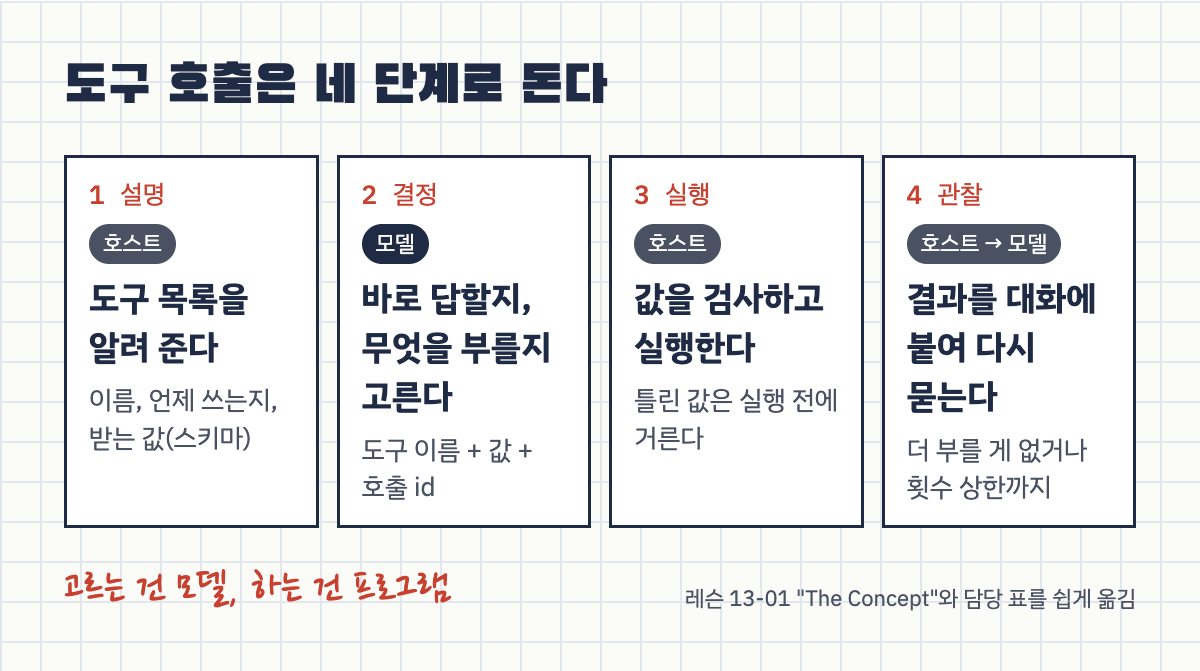
그림 2. 고르는 건 모델이고, 실행하는 건 프로그램입니다.
4단계 관찰이 바로 1화의 "관찰"입니다. 도구 결과가 대화에 붙어 돌아오기 때문에, 모델은 그걸 읽고 다음 행동을 고칠 수 있습니다.
실행 전에 거른다: 값 검사와 확인 단계
모델이 쓴 호출이 늘 맞지는 않습니다. 원본 레슨 13-01 The Tool Interface는 모델이 없는 칸을 지어내거나 타입을 틀리는 일이 흔하다고 보고, 호스트가 실행 전에 스키마로 검사해야 한다고 말합니다.
레슨의 연습 문제 2번과 3번을 실행한 결과가 그림 3입니다. 두 숫자를 더하는 add 도구에 값을 세 가지로 넣고, 메일을 보내는 가짜 도구도 하나 붙였습니다.
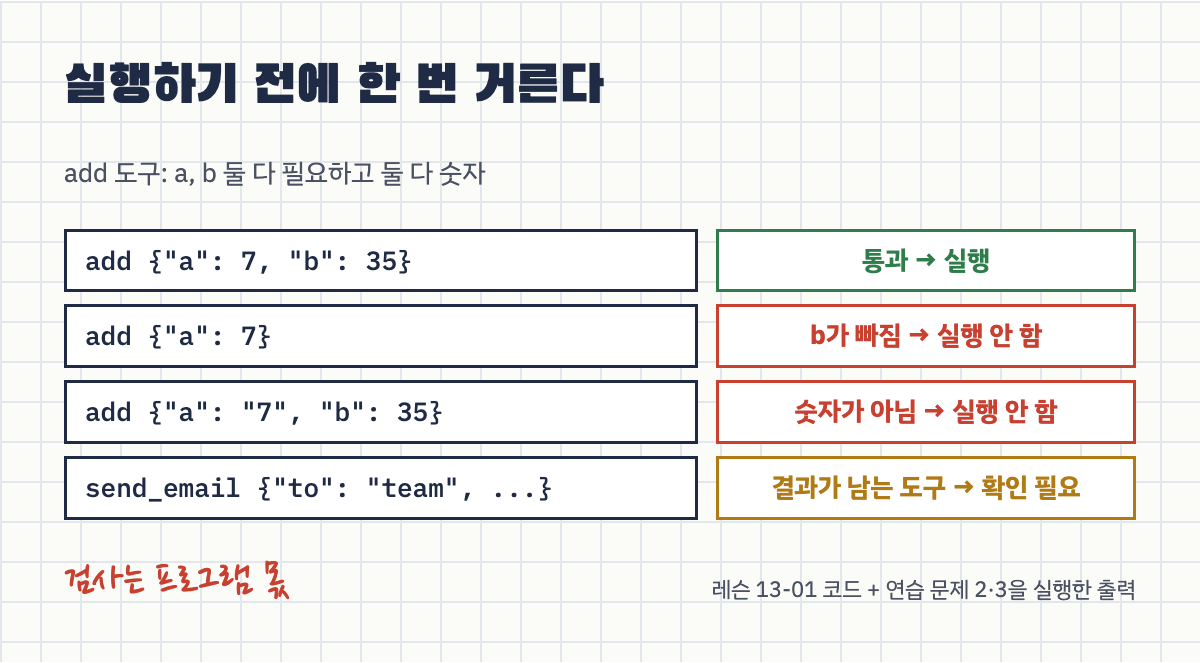
그림 3. 칸이 빠지거나 타입이 틀린 호출은 실행 전에 걸립니다.
여기서 눈여겨볼 점은 두 가지입니다.
- 검사는 모델이 아니라 호스트가 합니다.
- 레슨은 도구를 읽기만 하는 것과 결과가 남는 것(메일 보내기, 파일 지우기, 결제)으로 나눕니다. 결과가 남는 도구는 사람 확인을 거치게 하라고 권합니다. 다만 레슨 코드는 "확인하겠다"는 줄만 찍고 그대로 실행합니다. 실제로 멈추고 묻는 부분은 연습 문제로 비어 있습니다.
- 검사에 걸린 호출을 어떻게 할지도 레슨 본문과 코드가 다릅니다. 레슨 본문은 실제 서비스가 세 가지 중 하나를 한다고 설명합니다. 에러를 모델에게 알려 주거나, 깨진 JSON을 고치거나, 검사 에러를 넣어 모델에게 다시 묻는 것입니다. 레슨 코드는 에러를 출력하고 거기서 멈춥니다. 에러를 모델에게 돌려주는 쪽은 1화에서 본 "에러도 관찰" 구조와 같습니다.
0화에서 Claude Code가 파일 수정 전에 확인을 거친다고 했던 것도 같은 생각입니다. 고르는 것은 모델이 해도, 실행 직전의 문은 프로그램이 지킵니다.
회사마다 모양은 달라도 같은 구조
원본 레슨 13-02 Function Calling Deep Dive는 OpenAI, Anthropic(Claude), Google Gemini의 함수 호출 형식을 나란히 비교합니다. 칸 이름과 감싸는 위치가 다르고, OpenAI는 값을 JSON 문자열로, 나머지 둘은 객체로 돌려줍니다.
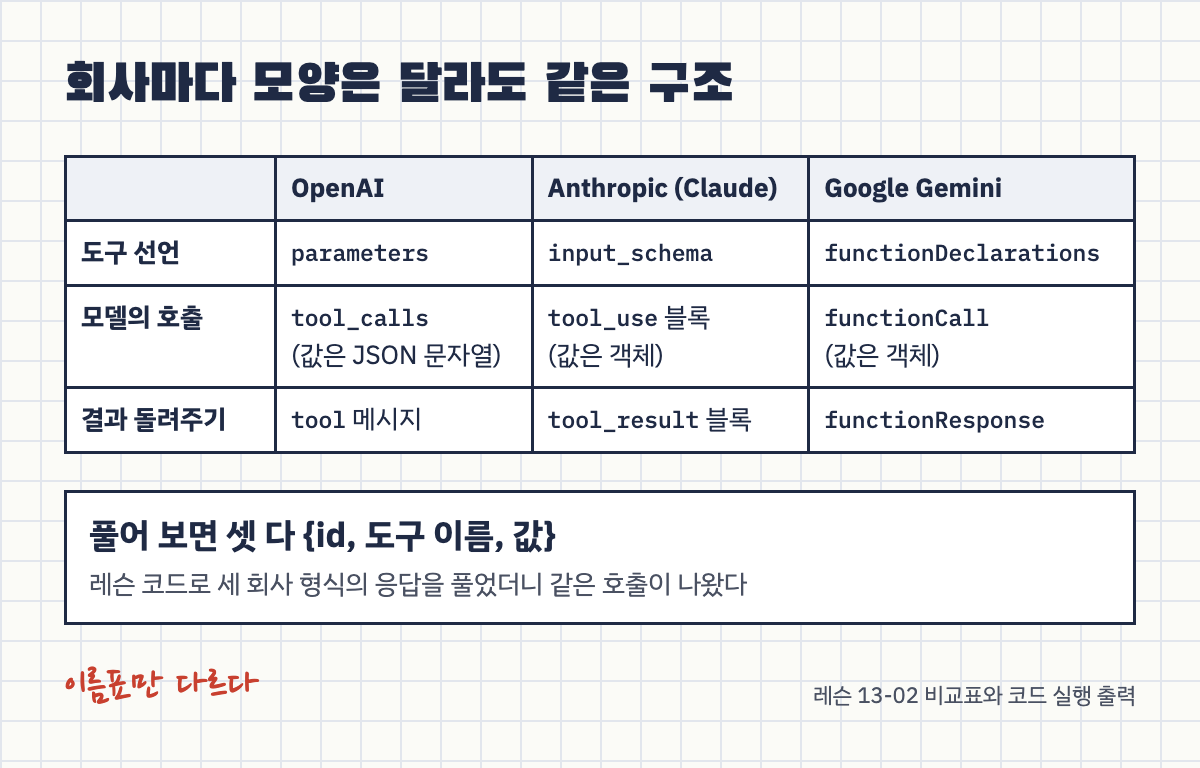
그림 4. 이름표만 다르고 구조는 같습니다.
레슨 코드로 세 형식의 응답을 풀면 모두 같은 도구 이름과 값이 나옵니다. 한 곳에서 배운 구조가 다른 곳에서도 그대로 통합니다.
레슨과 지금 공식 문서가 다른 점. 원본 레슨 13-02 Function Calling Deep Dive는 Anthropic(Claude)에 strict 모드 플래그가 없고, 모델이 스키마를 "대체로 지킨다"고 적습니다. 같은 레슨의 비교표에는 "항상 강제된다"고 적혀 있어 레슨 안에서도 설명이 엇갈립니다. 2026년 10월 기준 Claude API 공식 문서 "Strict tool use"는 도구 정의에 strict: true를 넣으면 Claude의 도구 호출이 스키마와 정확히 맞도록 보장한다고 설명합니다. 이 글은 공식 문서를 따랐습니다. API 기능은 빨리 바뀌니, 레슨이나 블로그 글보다 공식 문서를 마지막 기준으로 삼는 편이 안전합니다.
따라 해 보기: API 키 없이 도구 호출 루프 돌려 보기
원본 레슨 13-01 The Tool Interface와 13-02 Function Calling Deep Dive의 예제 코드는 API 키 없이 돌아갑니다. Python 3만 있으면 됩니다.
B=https://raw.githubusercontent.com/rohitg00/ai-engineering-from-scratch/main/phases/13-tools-and-protocols
curl -sfL "$B/01-the-tool-interface/code/main.py" -o tool_interface.py && python3 tool_interface.py
curl -sfL "$B/02-function-calling-deep-dive/code/main.py" -o function_calling.py && python3 function_calling.py
첫 번째 파일은 DECIDE, EXECUTE, OBSERVE 순서로 네 단계를 찍습니다. 그다음 파일 맨 아래 질문 목록의 "please add 7 and 35"를 "please add 7"로 바꿔 다시 돌려 보세요. 숫자가 하나뿐이라 덧셈 도구가 불리지 않고, 맞는 도구가 없다는 답이 나옵니다. 두 번째 파일은 같은 도구가 세 회사 형식으로 어떻게 바뀌는지 보여 줍니다.
단, 예제의 "모델"은 키워드로 도구를 고르는 가짜 함수입니다. 실제 언어 모델로 바꾸면 결정 단계만 달라집니다.
자주 묻는 질문
Q. 함수 호출을 하면 AI가 직접 프로그램을 실행하나요? 아닙니다. 모델은 "이 도구를 이 값으로 불러 달라"는 요청만 씁니다. 실행은 앱이 합니다. Claude API 공식 문서는 앱이 실행하는 도구(client tools)와 Anthropic 서버에서 실행하는 도구(웹 검색 같은 server tools)를 나눠 설명하는데, 어느 쪽이든 모델 자신이 실행하는 구조는 아닙니다.
Q. 그냥 "JSON으로 답해"라고 시키면 안 되나요?
형식이 깨질 수 있습니다. 원본 레슨 13-01은 괄호 빠짐, 지어낸 칸, 틀린 타입을 예로 듭니다. 함수 호출은 호출을 답과 다른 칸에 담습니다. Claude API 공식 문서는 도구 정의에 strict: true를 넣으면 호출이 스키마와 정확히 맞도록 보장한다고 설명합니다.
Q. 도구 설명은 어떻게 써야 하나요? 원본 레슨 13-01의 예제는 "지금 날씨를 물을 때 쓴다. 예보나 지난 날씨에는 쓰지 않는다"처럼 쓸 때와 쓰지 않을 때를 함께 적습니다. 모델은 이 설명을 보고 도구를 고릅니다.
더 깊이: Toolformer, Gorilla, 강의, 코드
Toolformer 논문. Schick 외, "Toolformer: Language Models Can Teach Themselves to Use Tools"(arXiv 2302.04761, 2023년 2월). 초록의 주장은 세 가지입니다.
- 언어 모델은 예시 몇 개만으로 새 과제를 풀면서도, 산수나 사실 찾기 같은 기본기에는 약합니다. 훨씬 작은 모델이 더 잘하는 영역입니다.
- Toolformer는 어떤 API를 언제, 어떤 값으로 부르고, 결과를 다음 글자 예측에 어떻게 넣을지 스스로 배우게 한 모델입니다. API마다 시연 몇 개만 있으면 되는 자기 지도 방식입니다. 계산기, 질의응답 시스템, 검색 엔진 두 개, 번역기, 달력을 도구로 썼습니다.
- 여러 과제에서 제로샷 성능이 크게 오르고, 언어 모델 본래 능력은 유지됩니다.
Gorilla 논문. Patil 외, "Gorilla: Large Language Model Connected with Massive APIs"(arXiv 2305.15334, 2023년 5월). 초록은 당시 최고 모델도 API를 부를 때 정확한 값을 만들지 못하고, 잘못된 사용법을 지어내는 경향이 있다고 지적합니다. 문서 검색기를 붙여 미세 조정한 Gorilla가 API 호출 작성에서 GPT-4를 넘었고, 문서가 바뀌어도 따라간다고 보고합니다. 이 팀의 gorilla 저장소에는 함수 호출 평가 리더보드(BFCL)도 있습니다.
openai-agents-python 코드. OpenAI의 오픈소스 에이전트 라이브러리 openai-agents-python은 파이썬 함수에 @function_tool을 붙이면 함수 이름, 설명 주석(docstring), 매개변수로 도구 설명과 스키마를 자동으로 만듭니다. 1단계 "설명"이 실제로 어떤 JSON이 되는지 볼 수 있습니다.
Stanford CME295 7강 "Tool calling"(59:28). 강의는 이 글의 세 단계와 같은 흐름을 이렇게 나눕니다(1:08:20부터).
- 함수의 겉모양(이름, 입력, 출력, 설명)만 모델 앞에 넣습니다. 모델이 할 일은 함수를 짜는 게 아니라 "어떤 값을 넣을지" 채우는 것뿐입니다. 함수 안쪽 구현은 코드에만 있고 모델은 보지 못합니다.
- 호출을 실행합니다. 강의 표현으로는 "언어 모델과 아무 상관 없는" 단계입니다. 결과는 정해진 구조로 돌아옵니다.
- 결과를 모델에게 다시 넣어 사람 말로 답하게 합니다. JSON 그대로가 아니라 자연어 답이 목표입니다.
모델이 이걸 어떻게 배우는지도 다룹니다(1:11:14). 미세 조정(SFT)을 한다면 학습 쌍이 두 종류 필요합니다. 하나는 "질문 + 함수 설명 → 호출과 값", 다른 하나는 "지금까지의 대화 전체(질문, 호출, 결과) → 최종 답"입니다. 미세 조정 없이 프롬프트의 설명만으로도 할 수 있는데, 강의는 그 설명을 손으로 끝까지 쓰지 말라고 권합니다(1:17:39). 질문과 기대하는 호출을 짝지은 평가 묶음을 만들어 지금 설명을 채점하고, 점수를 추론 모델에게 주며 설명을 고치게 하라는 것입니다. 이 글 FAQ의 "도구 설명은 어떻게 써야 하나요?"에 대한 강의 쪽 답입니다.
도구는 세 갈래로 나눕니다(1:20:36): 정보 찾기(학습 이후 뉴스, 날씨, 주가), 계산(질문을 코드로 바꿔 실행), 사용자 대신 행동하기(메일 쓰고 보내기). 그리고 한계 세 가지를 짚습니다(1:24:13). 혹시 몰라 도구를 많이 넣으면 일부가 문맥 속에 묻히고, 문맥 창에는 끝이 있고, 회사마다 도구를 정의하는 방식이 달라 표준이 없습니다.
같은 강의 "Tool selection"(1:26:22). 도구가 많을 때의 해법으로 두 단계 "도구 선택기"를 소개합니다. 먼저 도구 이름과 한두 단어 설명만 담은 긴 목록을 주고 쓸 만한 것을 고르게 한 뒤, 고른 도구의 전체 설명만 문맥에 넣습니다. 라우터(router)라고도 부르며, 검색(RAG)으로 고를 수도 있지만 꼭 그래야 하는 건 아니라고 답합니다. 바로 이어지는 "표준이 없다"는 문제의 답이 MCP이고, 5화에서 다룹니다.
Stanford Webinar "Agentic AI"(Insop Song) 26:47. 언어 모델은 글을 받아 글을 내놓을 뿐이라 바깥 정보를 직접 가져오지 못한다는 데서 출발합니다. "샌프란시스코 날씨"를 예로, 날씨 질문이면 정해진 형식으로 출력하라고 프롬프트에 미리 알려 두면 그 출력을 소프트웨어가 읽어 날씨 API를 부르고, 결과를 모델에게 돌려줘 사람이 읽기 좋은 답을 만든다고 설명합니다. 모델이 코드를 만들고 바깥 샌드박스에서 실행하는 방식도 같은 틀로 소개합니다. (영상 설명란의 챕터는 16:30이지만, 자막 기준으로 도구 이야기는 26:47에 시작합니다.)
다음 화 예고. 모델이 무엇을 부를지 "결정"하는 단계는 결국 모델에게 어떻게 말하느냐에 달려 있습니다. 3화에서는 모델이 더 잘 생각하게 만드는 프롬프트 기법을 다룹니다.
원본: rohitg00/ai-engineering-from-scratch (MIT, © 2026 Rohit Ghumare). 이 글은 원문을 바탕으로 직접 정리하고 재구성했습니다.
출처
- rohitg00/ai-engineering-from-scratch, 13-01 The Tool Interface: https://github.com/rohitg00/ai-engineering-from-scratch/tree/main/phases/13-tools-and-protocols/01-the-tool-interface
- rohitg00/ai-engineering-from-scratch, 13-02 Function Calling Deep Dive: https://github.com/rohitg00/ai-engineering-from-scratch/tree/main/phases/13-tools-and-protocols/02-function-calling-deep-dive
- Schick et al., Toolformer (arXiv 2302.04761): https://arxiv.org/abs/2302.04761
- Patil et al., Gorilla (arXiv 2305.15334): https://arxiv.org/abs/2305.15334
- Claude API 문서, Tool use with Claude: https://platform.claude.com/docs/en/agents-and-tools/tool-use/overview
- openai/openai-agents-python (MIT): https://github.com/openai/openai-agents-python
- ShishirPatil/gorilla (Apache-2.0): https://github.com/ShishirPatil/gorilla
- Stanford CME295 Lecture 7 (Tool calling 59:28, Tool selection 1:26:22, 영어 자막 확인): https://www.youtube.com/watch?v=h-7S6HNq0Vg&t=59m28s
- Stanford Webinar, Agentic AI (Insop Song), 26:47 도구 사용 (영어 자막 확인): https://www.youtube.com/watch?v=kJLiOGle3Lw&t=26m47s