요약. Claude Code가 파일을 직접 고칠 수 있는 이유는 모델이 특별해서가 아니라, 언어 모델(LLM)에 도구와 반복 루프가 붙어 있기 때문입니다. 이 구조를 AI 에이전트라고 부릅니다. 챗봇과 에이전트의 차이, 에이전트가 일하는 방식을 공식 문서 기준으로 정리합니다.
Claude Code로 일하면서 생긴 질문
Claude Code를 쓰면서 가장 놀라웠던 점은 아이디어를 현실로 만들 수 있게 됐다는 것입니다. 많은 정보를 습득하고, 이해하고, 구현하는 과정이 굉장히 짧아졌습니다.
회사 일에서도 그 변화를 체감합니다. 요즘 Claude Code로 하는 일은 이런 것들입니다.
- 예측 결과를 검증하는 분석 리포트를, 전에는 며칠 걸리던 일을 반나절 만에 초안까지 만듭니다.
- 손으로 하던 자료 수집과 정리를 스크립트로 바꿔, 지금은 결과만 확인합니다.
- 사내 웹 서비스에 대화형 캐릭터를 붙이자는 아이디어를, 회의에서 말로만 하던 단계에서 바로 동작하는 시제품으로 만들었습니다.
- 회의 메모를 붙여 넣으면 정리된 회의록이 나오는 작업 지침서를 만들어 팀에서 쓰고 있습니다.
네 가지 모두 제가 코드를 한 줄씩 붙여 넣으며 한 일이 아닙니다. Claude Code가 직접 파일을 열고, 고치고, 명령을 실행하며 진행했습니다. 채팅창의 AI는 답을 글로 돌려주고, 붙여 넣고 실행하는 것은 사람의 몫인데 말입니다. 안에서 동작하는 언어 모델은 같은 종류인데, 무엇이 이런 차이를 만들까요?
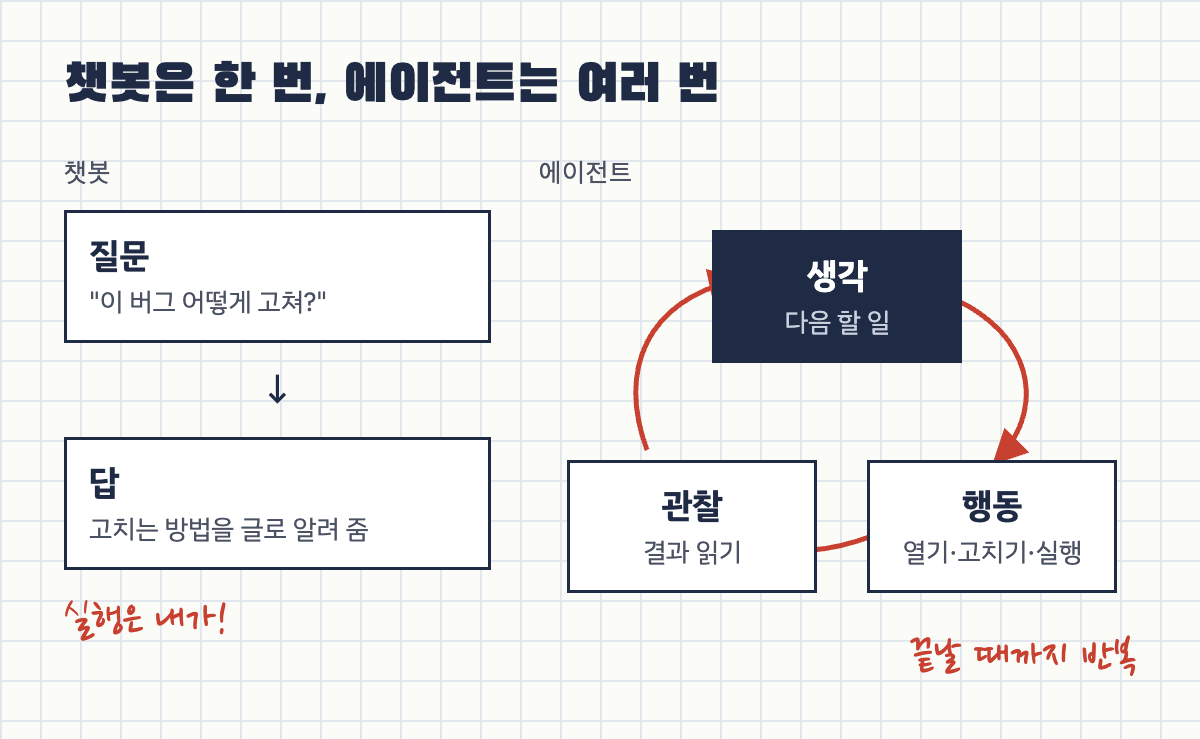
그림 1. 챗봇은 "질문 → 답" 한 번으로 끝나고, 에이전트는 결과를 보며 여러 번 움직입니다.
챗봇과 AI 에이전트의 차이: 전화로 알려 주는 친구와 옆에서 고쳐 주는 친구
챗봇은 전화 너머의 친구와 같습니다. "그 나사를 왼쪽으로 돌려 봐"라고 말은 해 주지만, 직접 돌리고 됐는지 확인하는 것은 나입니다.
에이전트는 옆자리에 앉은 친구입니다. 직접 나사를 돌려 보고 다음 할 일을 정합니다. 위험한 일 앞에서는 "해도 될까?" 하고 먼저 묻습니다.
AI 에이전트의 구조: 언어 모델 + 도구 + 루프
옆자리 친구를 실제 구성 요소로 나누면 세 가지입니다. 비유로 말하면 머리, 손, 반복에 해당합니다.
- 언어 모델(LLM): 상황을 읽고 다음에 할 일을 정합니다. (머리)
- 도구: 파일 읽기, 파일 수정, 터미널 명령 실행처럼 실제로 일을 하는 기능입니다. (손)
- 루프: 도구를 쓴 결과를 언어 모델이 다시 읽고 다음 행동을 고르는 과정을, 일이 끝날 때까지 되풀이합니다. (반복)
정리하면 AI 에이전트 = 언어 모델 + 도구 + 루프 입니다.
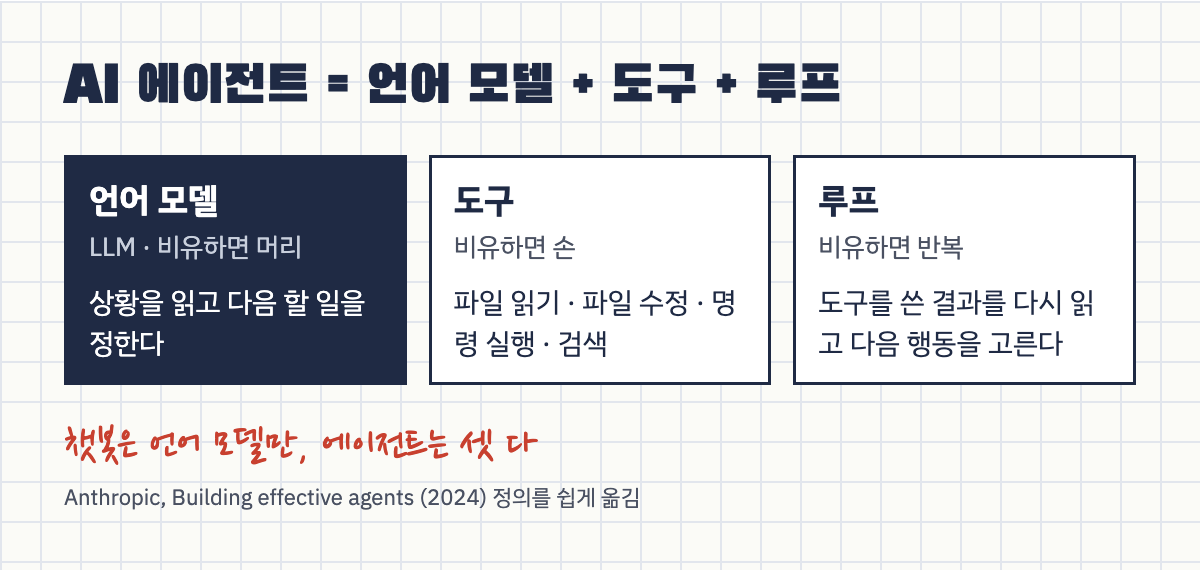
그림 2. AI 에이전트는 언어 모델, 도구, 루프 세 부분으로 이루어집니다.
에이전트 루프: 생각 → 행동 → 관찰
Claude Code에게 "실패하는 테스트를 고쳐 줘"라고 요청하면, 공식 문서는 다음과 같은 흐름을 예로 듭니다.
- 테스트를 실행해 무엇이 실패하는지 확인한다
- 에러 메시지를 읽는다
- 관련 파일을 찾아 읽는다
- 파일을 수정한다
- 테스트를 다시 실행해 확인한다
한 단계가 끝날 때마다 실행 결과나 에러 메시지가 다시 언어 모델에 입력되고, 모델은 그 내용을 읽고 다음 행동을 고릅니다. 생각하고, 행동하고, 결과를 관찰하고, 다시 생각하는 것입니다.
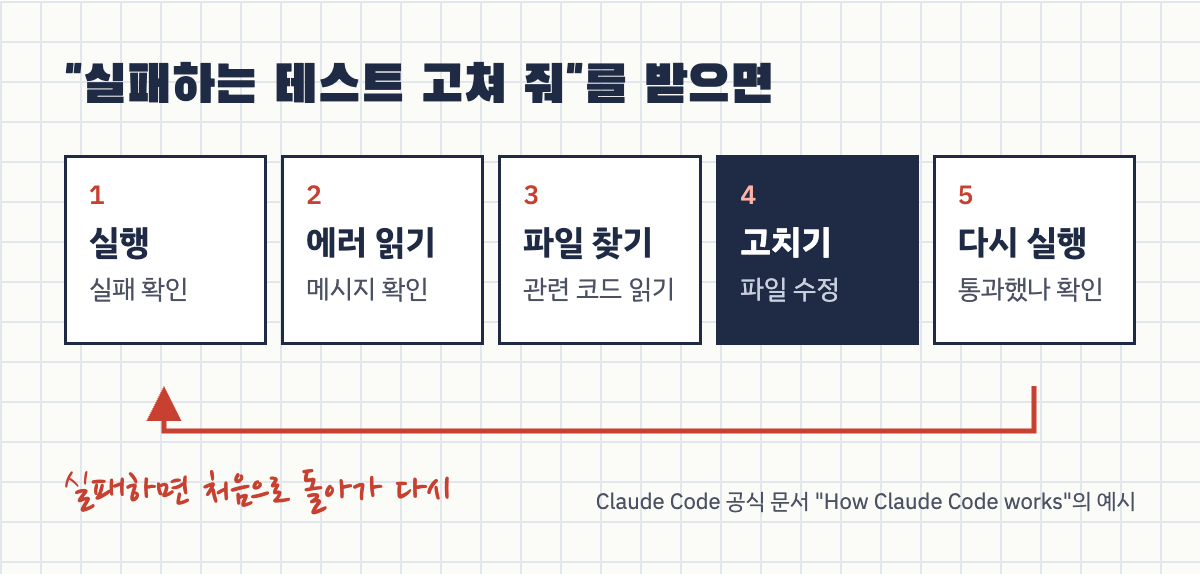
그림 3. "테스트 고쳐 줘" 요청 하나에 루프가 여러 번 돕니다. (Claude Code 공식 문서의 예시를 그림으로 옮김)
도구를 쓰는 에이전트의 안전장치
에이전트가 도구로 직접 파일을 고치고 명령을 실행하면, 실수도 실제 결과로 이어집니다. 그래서 Claude Code에는 두 가지 안전장치가 있습니다.
첫째는 권한입니다. 작업 폴더 안에서 파일을 읽는 것은 따로 묻지 않습니다. 하지만 파일을 고치거나 터미널 명령을 실행하기 전에는 먼저 허락을 받게 설정할 수 있습니다. 최근 버전에서 기본으로 켜지는 Auto 모드에서는 사람 대신 안전 분류기가 각 동작을 먼저 검토합니다. 안전 분류기는 동작이 위험한지 자동으로 판별하는 장치입니다.
둘째는 되감기입니다. 파일을 고치기 전의 내용을 저장해 두기 때문에, 잘못되면 되돌릴 수 있습니다. 다만 데이터베이스나 배포처럼 파일 바깥에서 일어난 일은 되돌리지 못합니다.
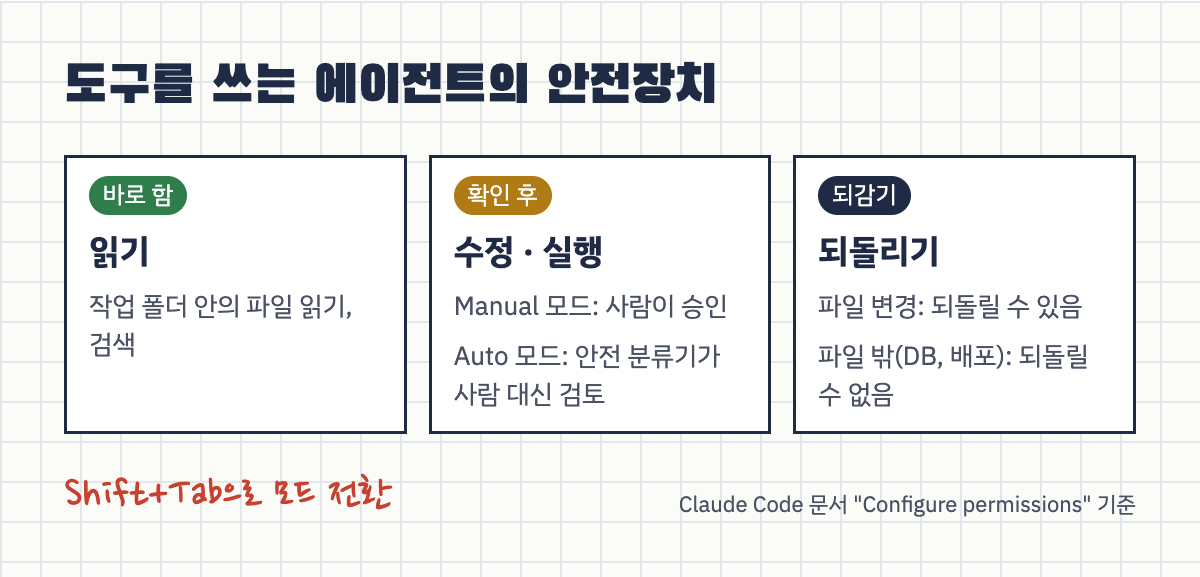
그림 4. 읽기는 바로, 수정과 실행은 승인이나 검사를 거치고, 파일 변경은 되감을 수 있습니다.
위험을 줄이는 방법이 하나 더 있습니다. 처음부터 AI에게 길을 맡기지 않는 것입니다. 순서가 정해진 일은 사람이 길을 미리 깔아 두는 편이 낫고, 이것을 워크플로라고 부릅니다. AI가 길을 스스로 고르게 할지, 미리 정해 둘지는 4화에서 자세히 다룹니다.
에이전트와 일할 때 사람이 하는 일
앞에서 말한 리포트와 시제품도 초안이 빨라졌을 뿐, 무엇을 만들지 정하고 결과가 맞는지 확인하는 것은 여전히 사람의 몫입니다. 에이전트가 루프 안에서 도구의 결과를 관찰하듯, 사람도 에이전트가 낸 결과를 관찰해야 합니다.
에이전트가 빨라질수록 사람의 일은 직접 손으로 하는 것에서, 무엇을 맡길지 정하고 결과가 맞는지 판단하는 쪽으로 옮겨 갑니다. 다음 회차부터 다룰 평가와 검증 게이트(4막)가 바로 이 판단을 돕는 장치입니다.
따라 해 보기: 에이전트가 도구를 몇 번 쓰는지 세어 보기
공개 저장소 하나로 직접 확인해 볼 수 있습니다.
git clone https://github.com/karpathy/minbpe.git
cd minbpe
claude
그다음 "이 폴더가 어떤 프로젝트인지 세 줄로 설명해 줘"라고 입력합니다. 화면에 파일을 읽는 줄이 몇 번 지나가는지 세어 보면, 에이전트 루프가 도는 모습을 볼 수 있습니다.
자주 묻는 질문
Q. AI 에이전트와 챗봇은 무엇이 다른가요? 챗봇은 질문에 답을 한 번 돌려주고 끝납니다. AI 에이전트는 도구를 써서 직접 행동하고, 그 결과를 보고 다음 행동을 정하는 과정을 일이 끝날 때까지 반복합니다.
Q. Claude Code는 파일을 마음대로 고치나요? 아닙니다. 파일 수정과 명령 실행은 실행 전에 확인을 거칩니다. Manual 모드에서는 사람이 직접 승인하고, Auto 모드에서는 안전 분류기가 사람 대신 검토합니다. 파일 변경은 되감기로 되돌릴 수도 있습니다.
Q. 모든 업무에 에이전트를 써야 하나요? 그렇지 않습니다. Anthropic은 단순한 방법으로 시작해 부족할 때만 에이전트를 더하라고 권합니다.
더 깊이: 공식 문서와 강의로 보는 에이전트
에이전트의 정의. Anthropic의 글 "Building effective agents"(2024년 12월)는 AI 시스템을 두 가지로 나눕니다. 워크플로는 LLM과 도구를 미리 정한 코드 경로로 엮은 것이고, 에이전트는 LLM이 자신의 과정과 도구 사용을 스스로 정하는 것입니다. 같은 글은 에이전트를 "환경의 피드백을 보며 루프 안에서 도구를 쓰는 LLM"으로 요약합니다.
Claude Code의 구조. 공식 문서 "How Claude Code works"는 루프를 맥락 모으기, 행동하기, 결과 확인하기의 세 단계로 설명합니다. 루프는 추론하는 모델과 행동하는 도구로 돌아가고, 그 둘레에서 도구를 제공하고 모델이 볼 맥락을 관리하는 층을 하네스(harness)라고 부릅니다. 권한 모드는 Shift+Tab으로 바꿀 수 있습니다.
작업 지침서 = 스킬. 앞에서 작업 지침서라고 부른 것은 Claude Code의 스킬(skill) 기능입니다. SKILL.md에 절차를 적어 두면 필요할 때만 불러와 씁니다. 7화에서 따로 다룹니다.
강의. Stanford CME295 9강 38:37부터 도구를 쓰는 LLM을 정리합니다.
다음 화 예고. 생각과 행동을 번갈아 하게 하면 더 정확해진다는 연구가 ReAct(2022)입니다. 1화에서 이 고리를 코드로 살펴봅니다.
시즌 1 구성: 에이전트에서 시작해 원리로
이 시리즈는 공개 커리큘럼 ai-engineering-from-scratch(20개 단계, 523개 레슨)를 바탕으로 합니다. 원본은 수학에서 에이전트로 올라가지만, 이 시리즈는 거꾸로 매일 쓰는 에이전트에서 출발해 한 층씩 원리로 내려갑니다.
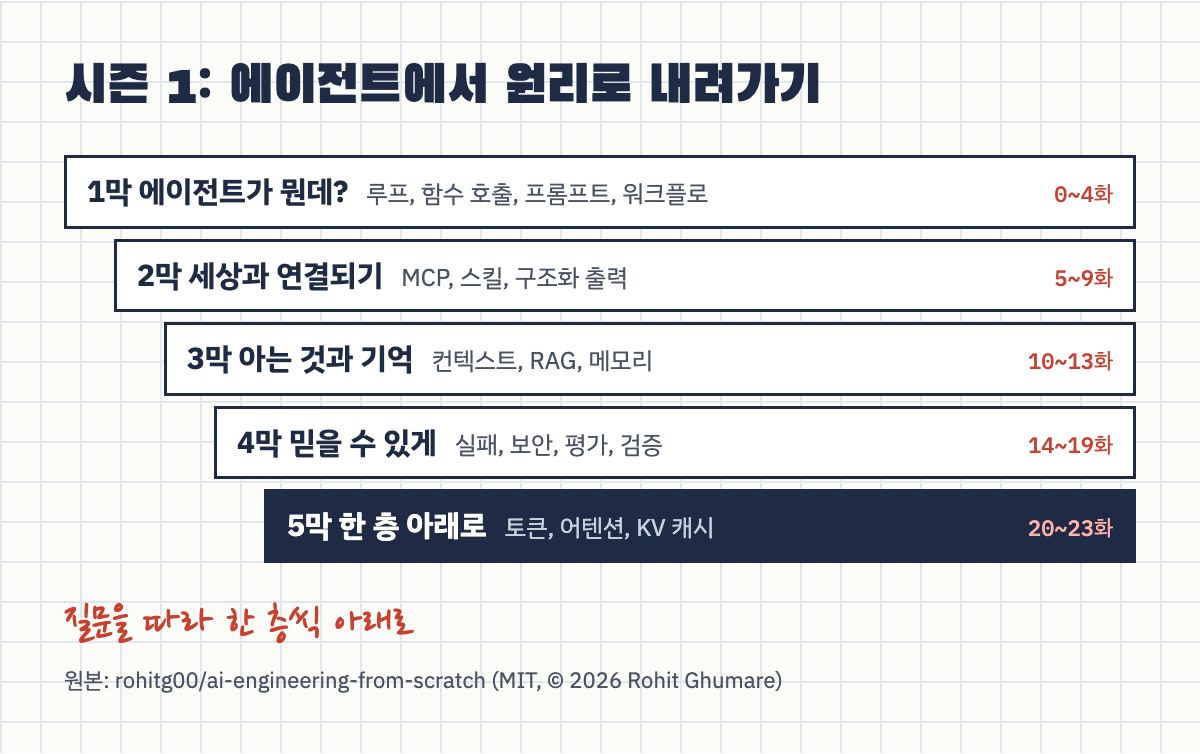
그림 5. 시즌 1은 다섯 막, 25화로 구성됩니다.
원본: rohitg00/ai-engineering-from-scratch (MIT, © 2026 Rohit Ghumare). 이 글은 원문을 바탕으로 직접 정리하고 재구성했습니다.
출처
- Anthropic, "Building effective agents" (2024-12-19): https://www.anthropic.com/engineering/building-effective-agents
- Claude Code 문서, How Claude Code works: https://code.claude.com/docs/en/how-claude-code-works
- Claude Code 문서, Configure permissions: https://code.claude.com/docs/en/permissions
- Claude Code 문서, Skills: https://code.claude.com/docs/en/skills
- Lilian Weng, "LLM Powered Autonomous Agents" (2023-06-23): https://lilianweng.github.io/posts/2023-06-23-agent/
- Yao et al., ReAct (arXiv 2210.03629): https://arxiv.org/abs/2210.03629
- Stanford CME295 Lecture 9, 38:37 Agentic LLMs: https://www.youtube.com/watch?v=Q86qzJ1K1Ss&t=38m37s
- rohitg00/ai-engineering-from-scratch: https://github.com/rohitg00/ai-engineering-from-scratch
- karpathy/minbpe (MIT): https://github.com/karpathy/minbpe
'AI > Engineering' 카테고리의 다른 글
| MCP 서버 만들기: Python SDK로 함수 세 개, 26줄 첫 MCP 서버 (직접 짜면 400줄인 이유까지) (0) | 2026.10.20 |
|---|---|
| MCP란? AI 앱과 도구를 잇는 표준 규격 MCP 구조 쉽게 정리 (호스트·클라이언트·서버, 도구·리소스·프롬프트) (0) | 2026.10.18 |
| 모든 AI 일을 에이전트로 시켜야 할까? 워크플로와 에이전트의 차이, 워크플로 패턴 5가지 쉽게 정리 (0) | 2026.10.15 |
| AI에게 "단계별로 생각해 봐"라고 하면 정말 더 잘할까? 프롬프트 기법 쉽게 정리 (퓨샷, 생각의 사슬) (0) | 2026.10.12 |
| AI 에이전트는 왜 몇 번씩 다시 시도할까? ReAct 루프 쉽게 정리 (생각·행동·관찰) (0) | 2026.10.06 |